2026-10-20 从 OpenDriveTester 到 PXDT3:存储测试工具的三代演进
- 作者视角:项目开发者
- 更新日期:2026-10-20
- 项目沿革:OpenDriveTester → PXDriveTester / libpxdt → PXDT3
- 资料来源:作者经历、项目源码与存储测试工具研究记录
学生时代,我想模仿 URWtest 和 H2testw,做一个跨平台可用的存储测试工具,于是有了 OpenDriveTester。大学期间,一次为工厂开发软件的外包,让这个兴趣进入了生产现场:我开发了 PXDriveTester 和 libpxdt,将格式化、设备信息、测速和写入校验接到同一个应用里,实际投入过生产。
这次重新做 PXDT3,有两个直接原因。我一直缺少一个能跨平台、用统一方法比较设备的一站式工具;工厂又提出了新的 NVMe 设备定位需求,需要把系统发现的设备可靠地对应到物理工位、PCIe 端口或插槽。我决定先构建跨平台底层基座,再接上设备管理与工厂流程。
现在,这个基座已经向上延伸到跨平台 Workbench、独立 Node 和多目标编排,CLI/Core 也在 Android 的 Termux 环境积累了文件测试、原生健康查询与 I/O 后端选择的实机记录。物理定位从最初的 NVMe 需求扩展到 USB、SATA/SAS 和机箱盘位:软件已能记录拓扑、校准工位并管理定位请求,接下来要用真实板卡、线缆和背板验证这些关系。前半篇保留三代工具的研发经历,后半篇记录这套工作台截至 10 月 20 日的实现。
最近一轮优化围绕三个问题展开:手机内核允许使用哪条 I/O 路径,设备健康字段究竟来自主动查询还是内核缓存,以及图表和结果能否准确保留已完成的工作。它们共同影响工具的可信度:同一份计划需要有明确的执行方式,同一个数字需要能追到来源,同一次取消也需要留下完整的收尾状态。
这个核心需要回答三个具体问题:写入的数据能否完整读回,不同负载下的性能怎样,以及持续运行时是否还能保持正确。命令行、桌面软件和工厂系统,应当能够使用同一套测试逻辑。围绕它,还要逐步解决设备身份、物理位置和结果追溯。
三代项目都围绕“生成数据、写下去、读回来”展开。随着目标变化,需要解释的事情越来越多:期望数据从哪里来,程序显示的完成量意味着什么,随机访问究竟检查到了哪些位置,几种测速工具为什么会给出不同数字。
这篇研发复盘沿着这些问题展开。主文保留项目演进与设计取舍,算法推导、逆向过程和 I/O 生命周期放在默认折叠的技术段落中。只读主文,可以看清三代工具的变化;展开细节,则能继续追到数据格式、请求状态与测量方法。
OpenDriveTester 从模仿经典工具开始
OpenDriveTester,简称 ODT,是这条项目线的第一代。最初的想法很直接:既然可以生成一份已知数据,写到 U 盘或 SSD,再读回来比较,就可以自己实现一个存储测试程序,并尝试让它跨平台使用。
ODT 使用 Java,数据来自 Java Random,设计了自己的 ODTD 文件格式,支持固定种子和随机种子。命令行提供只写、只校验、写入后校验以及循环测试。固定种子便于重建相同数据;随机种子则需要通过文件格式保留恢复数据序列所需的信息。这些设计已经在处理后来仍然重要的问题:测试数据怎样生成,怎样再次验证,以及一次测试应该留下什么。ODT README保留了当时的用法。
跨平台的愿望也从这里开始。语言能在不同系统上运行之后,存储测试仍要面对各平台的缓存策略、文件打开方式和设备识别方式。对测试工具而言,能打开一个文件只是起点,写入什么时候完成、读取经过了哪些缓存,同样影响结果的含义。
ODT 细节:固定种子、55 字节元信息与缓存调用的位置
回看 Odtd.java,固定种子与随机种子模式采用了不同的文件布局。固定模式直接写数据,没有 ODTD 头;随机模式先写入 7 字节的 ODTD1.0 标识、8 字节创建时间、8 字节完成时间,以及四份各 8 字节的种子,再写入数据。按实际写入操作相加,元信息共 55 字节。
这里我以代码中的长度和写入顺序为依据。旧代码的个别注释与实际常量已有出入,例如实际缓冲区大小是 512 * 1024,旁注却写着 256 KB。重新研究自己的旧项目时,注释可以帮助找到入口,最终的数据布局仍要沿真实调用检查。
固定模式每个文件都从相同 seed 重新构造 Java Random。因此,在文件内相同的位置,完整数据块会在不同文件间重复。它能检查读回内容是否符合该序列;若把两个文件的对应内容互换,仅靠这种重复图样就缺少区分它们的依据。随机模式保存各自的 seed,解决了重新验证时如何找回序列的问题,文件元信息也因此成为恢复期望内容的依赖。
另一个取舍是定位能力。常规 PRNG 按状态顺序前进,从文件中间开始校验时,需要恢复相应状态,或从已知起点推进到那里。顺序整文件测试可以自然地沿序列前进;当需求变成并行分段、随机读回和中断恢复时,按位置直接生成内容会更容易组织。
ODT 默认以 2 GiB 分段,读写循环按 512 KiB 缓冲区推进。旧实现每轮分配缓冲区,校验时还生成一份期望数组,最后逐字节比较;循环中存在 Thread.sleep(1)。这些细节意味着,端到端耗时同时受到分配、发生器、比较和调度影响。仅靠语言名称,无法解释一个测试程序的实际吞吐。
源码里还有一次 force(false),但它位于新建输出流之后、后续数据写入之前。同步调用只针对调用时点之前的相关写入;这个位置无法说明后续每一块数据都绕过了缓存。要判断缓存行为,需要同时查看文件打开选项、写入路径、同步时点和重开方式。
这段实现让我更具体地理解了“可再次校验”的含义。程序要么约定所有重建参数,要么把它们保存下来;同时还要知道文件所属的数据集及位置。种子恢复解决内容序列,位置标识解决内容归属,这两个问题在第一代里还没有统一起来。
PXDriveTester 和 libpxdt 进入工厂
大学期间,我承接了工厂的软件外包,开发第二代 PXDT,也就是 PXDriveTester 和 libpxdt。这套软件实际用于过生产,需求也比 ODT 更完整:先找到设备、准备分区和文件系统,再测速、写入、读回,并把过程与结果交给操作者。
当时我大量复用成熟组件,将自己开发的部分集中在测试与流程整合上。
| 组件 | 在第二代项目中的职责 |
|---|---|
| 傲梅 AOMEI CLI | 分区与格式化,准备测试环境 |
| Microsoft DiskSpd | 执行性能测试 |
| CrystalDiskInfoEmbedded | 设备发现与 SMART 信息读取 |
| 自行开发的 libpxdt | 测试数据生成、写入与读回校验 |
| PXDriveTester | 桌面交互、流程组织和结果展示 |
libpxdt 的算法与实现参考了 URWtest,我也与 URWtest 作者沟通过,再完成自己的实现。这里的参考落实到了数据生成和读写组织;测速与格式化则直接调用现成软件。几种复用方式各有分工。
第二代形成了“库与应用分开”的结构:libpxdt 是 Windows C++ / MFC DLL,PXDriveTester 是 .NET 5 / WPF 应用,通过 P/Invoke 调用测试库。这个拆分延续到了第三代。它允许界面围绕现场操作组织,而测试算法和 I/O 保留在独立模块中。
源码中的 Drive.cs 把格式化、测速和写读校验组织成可选阶段。格式化路径调用 PartAssist 删除分区、创建 NTFS,再查询卷;测速准备 pxdt.dat,调用 DiskSpd;随后进入 libpxdt 的写入与读回。这些调用说明了程序如何组合组件,本文的复盘主要围绕这条技术路径展开。
成熟工具节省了实现各个子系统的时间,同时把难点推到了组件之间。某一步失败后能否继续,磁盘与卷如何关联,外部进程返回了什么,库里发现的数据错误怎样进入最终结果,都需要应用自己接好。随着流程变长,阶段结果比一个总进度条包含更多必要信息。
重新审视旧代码时,我也看到了当年的实现需要补强的地方。异步写入尚未结束,缓冲区是否已经开始填下一批数据?多个测试任务是否共享了随机数状态?底层读写失败之后,界面拿到的究竟是函数返回值,还是完整的测试结论?这些问题让第三代的设计重点逐渐明确。
技术细节:在途缓冲区与完成量决定校验是否可信
旧 libpxdt 使用 xorshift32,以 1 MiB 块读写,单个文件最大 2 GiB。每个文件以 RAND_SEED + 文件号 初始化状态,再连续生成该文件的数据。它与 ODT 的每文件相同固定 seed 有所不同,也与后来还原出的 URWtest xorshift128 有区别。
这个 xorshift32 的核心可以写成下面的形式,所有运算在 32 位无符号整数上进行:
text
x ^= x << 13
x ^= x >> 17
x ^= x << 5
移位与异或很便宜,适合持续生成数据。但发生器状态放在哪里,同样重要。旧实现把 seed 保存为类级静态状态;如果两个任务交错修改它,一个任务的下一块内容就可能受到另一个任务影响。把状态限制在任务或独立生成上下文中,才能让输出由该任务自己的输入决定。
静态代码检查还发现,部分写路径会在上一次异步写完成之前生成下一块数据,并提前修改复用的 OVERLAPPED。这涉及请求生命周期:异步函数返回“已提交”后,操作系统仍可能读取调用方的内存,此时填入下一块内容,会让实际写出的数据取决于竞争时序。
一个异步请求提交后,操作系统仍可能引用调用方提供的内存。因此,缓冲区、文件句柄和请求结构都要保持有效,直到完成被确认。读取还多一个阶段:内容比较结束,缓冲区才能交给下一个请求。
一个请求至少有三种不同的数量:计划处理多少字节,已经提交多少字节,操作系统确认完成多少字节。完整性测试还要再记录成功比较了多少字节。旧路径按请求大小推进某些计数,却没有在相同位置核对实际完成长度。PXDT3 把这些量分开,用有界请求槽位承载生命周期,使短读、短写、失败和取消保留各自的结果。
应用层还需要完整接收这些结果。P/Invoke 函数正常返回,只说明调用控制流回到了宿主;底层发现了什么错误、哪个阶段完成、是否还有请求在途,需要另外通过结果和状态表达。这里讨论的是历史源码中的风险条件,现场是否触发过某个问题仍需当年的运行记录支持。
重新研究经典工具 把测试方法拆开
开发 PXDT3 时,我回头研究了 H2testw、URWtest、AS SSD Benchmark、CrystalDiskMark / DiskSpd 和 PassMark BurnInTest。它们分别帮助我理解数据图样、性能工况和老化流程。
| 参考对象 | 重点研究的问题 | 在 PXDT3 中的取舍 |
|---|---|---|
| H2testw、URWtest | 数据如何重建,怎样读回比较,错误如何定位 | 保留原版发生器;设计适合任意位置重建的默认图样 |
| AS SSD Benchmark | 定量写入、重复读取与计时范围 | 提供 Write-based 测速模式 |
| CrystalDiskMark / DiskSpd | 顺序与随机负载、队列与线程、定时采样 | 提供 Time-based 模式与明确的工况参数 |
| PassMark BurnInTest | 多种数据模式、循环、随机压力与停止条件 | 实现普通文件 Burn-in,并保留独立的覆盖和完成判定 |
有源码的项目,沿着参数、执行循环和统计函数检查;没有源码的程序,就固定版本与文件散列,再研究机器码或中间语言。逆向分析的目标是弄清一个可验证的问题,例如“这个随机块是否每次重新生成”“这个速度数字的计时包含哪些步骤”。
这也改变了我看待测试分数的方式。相同的“随机”标签可能描述随机内容,也可能描述随机访问位置;相同的“平均速度”,可能只累计 I/O 调用耗时,也可能包含数据生成与比较。先还原这些定义,才知道自己要继承哪种方法。
逆向方法:UPX 解包、IDA 与 ILSpy 分析,再用 Unicorn 核对算法
URWtest 的固定样本最初只显露出少量函数,主要是装载与解压代码。如果直接围绕它们展开分析,很容易把壳的代码当成程序主体。检查后发现,经典 UPX 标识被改名;在副本中恢复三处四字节标识,再用标准 UPX 解包,才进入真正的测试逻辑。
解包之后,我先关注操作系统接口及调用者。ReadFile、WriteFile、同步和线程函数把范围缩小到 I/O;围绕缓冲区写入的短循环可能是发生器;围绕两个内存区域的读取、比较和分支可能是校验器。再把局部函数放回调用图,追踪数据从哪里来、谁持有它、何时比较、错误怎样传出。
反编译器给出的类型需要再次确认。32 位程序计算 64 位整数时,乘法可能拆成多组低位与高位运算;有符号和无符号类型推断不同,也会改变右移或比较的解释。还原递推关系时,我会回到汇编确认位宽、溢出和移位语义,再整理成可独立实现的公式。
H2testw 的发生器尤其适合做独立验证。它把数据划分成 512 字节单元,每单元包含 64 个小端 uint64:第一项保存该单元在数据集中的字节偏移,其余项由线性同余递推产生。
text
s = 当前单元的全局字节偏移
word[0] = s
for j = 1..63:
    s = (s * 0x10000000F + 17) mod 2^64
    word[j] = s
我用独立 Python 公式生成期望数据,再让 Unicorn 执行原程序的 x86 发生器,逐字节比较。H2testw 在 0、1 GiB、4 GiB、1 TiB 四个位置各生成 1 MiB;URWtest 比较连续两个 1 MiB 块及其最终状态,结果全部一致。URWtest 还原出的发生器是 xorshift128,与旧 libpxdt 的 xorshift32 有区别。
这些样本的选择有具体目的。跨过 32 位边界的起点,可以帮助发现只处理地址低位的问题;连续两个块与最终状态一起比较,可以检查状态是否跨块正确延续。大小端颠倒、初值少推进一次、最后一个字遗漏,都可能让伪代码看起来合理,却在逐字节比较时暴露出来。
AS SSD Benchmark 的对应样本是 .NET 程序,因此使用 ILSpy,并以 IL 核对关键循环与计时边界。BurnInTest 则通过 IDA 追踪普通文件测试、数据复用、计时和停止分支。
对性能路径,我会把计时器的起止位置单独标出来:分配缓冲区是否包含在内,第一次读取是否舍弃,生成与比较是否在计时区间中,外层按时间停止时内层是否仍需完成整遍。几条分支和计时调用,就可能改变最终成绩的解释。固定版本、文件散列、函数路径和核对记录一起保存,结论才能在后续修改时继续追溯。
这些方法形成互相校验的证据:反编译帮助理解流程,汇编或 IL 确认执行细节,独立公式与模拟执行核对算法字节。这里的模拟运行限于内存函数;文件系统行为和介质表现,需要另行运行验证。
数据图样先决定期望内容怎样重建
一个完整性测试需要知道“这里应该是什么”。这个答案可以来自连续 PRNG 状态,也可以直接由当前位置计算。前者自然适合顺序流,后者更适合并行分段、随机读取和恢复。它们对数据组织和任务调度提出了不同要求。
H2testw 把全局地址写进每个 512 字节单元,再从它生成剩余内容,因此可以独立重建中间任意单元。URWtest 的对应样本使用连续的 xorshift128 状态,并通过双缓冲组织计算与读写。数据发生器与 I/O 流水线分别解决内容和执行问题,需要分开理解。
图样取舍:地址线索、连续 PRNG 与双缓冲各解决什么
H2testw 首个 64 位字提供了一个易于恢复的地址线索。假设期望读取 A 单元,却读到了疑似 B 单元的内容,可以从首字得到候选 B,再重建 B 的完整 512 字节。完整匹配后,才有更强依据描述“内容与另一个位置的图样一致”。只看首字,随机损坏也可能碰巧产生看似有效的地址。
这种方法让故障描述更具体。内容全零、某些位变化、整个单元对应另一个地址,是不同的观测现象。但文件内容通常无法唯一确定错误发生在 NAND、控制器、桥接芯片、驱动还是主机内存。诊断先描述看到了什么,再结合设备和系统证据缩小原因范围。
URWtest 1.8 fix 的 xorshift128 使用四个 32 位状态字,通过移位、异或和状态轮换持续输出。下一块接着上一块的状态生成,状态还会连续跨越文件。顺序写入和读回时,两侧按相同顺序推进即可;如果多个线程要独立从不同位置开始,就需要提供正确的起始状态,或引入相应的跳转和状态管理。
它的双缓冲安排让一块内存交给 I/O,另一块交给数据生成或比较,再在同步点交换角色。对应 worker 使用同步 ReadFile / WriteFile。这实现了计算与 I/O 的重叠,但应用持有两块内存、系统中存在两个请求、设备内部同时执行两条命令,分别属于不同层次的事实。
假设生成一块内容要花 G 时间,写入要花 W 时间,完全串行时每块约需 G+W;理想重叠后,稳定阶段受较慢的一项约束,还要加上交接开销。这个简单模型解释了流水线为什么有用,也解释了为什么增加缓冲区之后,速度仍可能受发生器或比较器限制。
我因此更重视图样的可解释性。测试内容看起来杂乱,无法单独证明它更适合检出某种错误。要评估图样,需要具体检查位置区分、重复关系、状态恢复、位分布与计算成本,再配合故障注入或真实故障样本验证。
PXDT3 用位置相关数据支持完整校验
PXDT3 的默认图样 pxdt3-lcg64-512 按位置和计划指定的数据代次生成内容。代次 generation 默认为 0;知道测试范围内的字节偏移与这个固定参数,就能重建那里的期望内容,读取中间一段时也能独立校验。
这对于并发、恢复和错误定位很有用。如果本应位于 A 的数据读回来却像是 B 的内容,可以尝试按 B 重建整个单元,再确认是否发生了地址错置。报告因而能给出更具体的内容现象;至于故障来自介质、桥接芯片、驱动还是主机,则继续结合其他证据排查。
算法设计:512 字节独立重建,融合比较覆盖每个字节
默认图样以 512 字节为逻辑单元,每个单元独立设置起点,产生 64 个小端 uint64。所有运算按 uint64 溢出规则进行:
text
x = 0x9E3779B97F4A7C15 + offset / 512
repeat 64 times:
    emit LE64(x)
    x = x * 6364136223846793005 + 1442695040888963407 + generation
512 字节是数据格式与诊断粒度,实际 I/O 请求可以是数 MiB。逻辑单元大小与设备物理扇区大小分别描述不同层次。
这里的 offset 是测试数据集中的全局字节偏移,单元序号为 offset / 512。generation 是固定的 uint64 参数,进入每一步递推的增量;默认 0 时就是原先的默认图样。文件分段和线程划分只改变谁来处理这段内容,同一位置和代次的期望值保持一致。一个线程校验前半段、另一个线程校验后半段时,两者无需共享可变 PRNG 状态。
线性同余关系还提供了一个实用的优化。把乘数记为 A、包含固定 generation 的增量记为 C,第 n 个单元的起点记为 base + n,则单元内第 j 个字是初值的仿射函数:
text
x_j(n) = A^j * (base + n) + C * (1 + A + ... + A^(j-1))
x_j(n + 1) - x_j(n) = A^j
以上关系都在模 2^64 下成立;j 从 0 开始,j 为 0 时求和项为空。相邻单元的同一位置只相差一个固定步长。因此,可以预先算出 64 个初始值和 64 个步长,沿单元推进时反复做加法,减少每个输出字都执行乘法的成本。优化保留原数据格式,已有文件依然按同一公式验证。
校验时,生成期望值与比较融合执行,省去一块完整期望缓冲区的构造。差异用 difference |= actual XOR expected 累积,任何不同位都会保留,避免用 XOR 总归约时多个差异互相抵消。
融合比较仍然检查实际数据的每个字节。正常路径只需回答“这一块是否完全相同”,发现差异后再进入较慢的诊断路径,定位首个错误、差异分布或候选地址。这样可以减少正常数据上的额外内存流量,同时保留错误发生后的细节。
CPU 优化也要遵守相同的字节定义。现在的实现已经把连续单元展开为独立 lane 的加法推进,让编译器有机会合并计算。生成与完整比较仍使用同一份 Rust 规则;指令如何组合,继续通过编译结果和实际负载检查。
这个发生器是可预测的测试图样,目标是让每个位置的期望内容易于重建、完整比较和诊断。跨轮次的新旧内容识别,则需要在恢复设计里另外处理。
编译器已经生成 SSE2 与 NEON,独立加速后端先缓一缓
研究硬件加速时,一个影响后续方向的发现是:现有 Rust 循环已经能被编译器向量化。前面把相邻单元转成固定步长加法,让多个互不依赖的 lane 暴露在同一循环里;融合校验中的加法、异或和或运算,也适合成组处理。代码可以继续保持一份清楚的算法实现,同时使用 CPU 的 SIMD 指令。
我保留了一轮六目标的隔离函数代码生成检查。使用 Rust 1.99.0,将默认算法的生成与完整比较计算抽出,在优化级别 3 下编译为汇编;基线路径没有额外启用 AVX2,也没有使用针对开发机的 target-cpu=native。
| 隔离编译目标 | 生成路径 | 完整比较路径 |
|---|---|---|
| Windows MSVC、Linux GNU、macOS 的 x86_64 | 128 bit SSE2:paddq | paddq、pxor、por |
| Windows MSVC、Linux GNU、macOS 的 AArch64 | 128 bit NEON / Advanced SIMD:向量 add | 向量 add、eor、orr |
这解释了“通用 Rust 实现”实际可以怎样执行:一个向量包含多个数据元素,编译器把对应位置的运算一起安排。校验仍然比较全部内容,最后归约差异;它没有减少测试字节,也没有把校验换成抽样。另一组显式启用 AVX2 的包装函数生成了 256 bit 指令,说明编译器还可以利用更宽的目标能力。
因此,我暂缓了独立硬件加速后端的研究与实现。手写一套 SSE2、AVX2、NEON 或 GPU 路径,还会带来选择、回退、平台基线和逐字节一致性的维护工作。当前更有价值的顺序,是先检查实际发布产物,再确认真实负载中的瓶颈,只有收益足够明确时才增加专门实现。AES-counter 等新图样还会改变数据定义,需要连同恢复和错误诊断重新评估。
这轮 SIMD 检查覆盖了什么,后续性能如何比较
检查提取了默认发生器的填充循环和 matches_native,将计算函数设为可内联,再用独立导出包装函数编译;参数包括 --edition=2024 --crate-type=lib -C opt-level=3 -C codegen-units=1 --emit=asm。这份证据回答的是:在该优化上下文中,编译器已经为六个指定目标生成了哪些计算指令。
完整程序还会受到内联边界、LTO、调用方式、链接和发布参数影响。下一步应检查实际 release 产物,并在目标机器测量。此次记录没有覆盖 Windows x86、Linux musl、Android,也没有检查 H2testw 与 URWtest 的发生器。
性能比较先固定算法字节、工作集和线程数,测量单核生成与完整比较,再放进同一 I/O 工况。吞吐之外,还看进程 CPU 秒/GB,分别观察缓存内和超过末级缓存的工作集。I/O 等待会降低表面 CPU 占用,短缓存窗口也可能放大吞吐;至少三轮交替样本及完整计时范围,才能解释优化有没有节省真实计算成本。
通用发布继续使用各目标的指令集基线。隔离 AVX2 包装仅用于能力检查,当前产品没有独立 AVX2 后端或供操作者切换的加速选项。若以后新增专用路径,仍要覆盖任意偏移、尾块、跨文件边界和故障注入,保留相同的数据定义。
文件和 checkpoint 分开 保存内容与保存进度
第三代把测试文件保持为纯数据,从第一个字节开始都遵循选定图样。文件名和分段规则负责组织数据集,可选 JSON checkpoint 负责记录运行进度。这使测试内容与任务状态各自清楚:读取某个位置时依照图样重建期望值,恢复任务时另外核对哪些分段已经可靠提交。
这样做也把中断恢复变成一个明确流程。记录显示某段已经完成后,恢复时先重新校验这部分;未提交的部分按完整分段重写,最后对全部范围再做完整校验。恢复的价值是复用可验证的已有工作,同时保留错误证据。
恢复顺序:先同步数据,再提交进度,恢复后仍然读回
一次提交涉及两类文件:测试数据,以及描述进度的 JSON。顺序必须让进度落后于可靠完成的数据。当前设计先完成分段写入并同步数据,再写入、同步临时 JSON,通过原子替换提交 checkpoint,最后推进已提交状态。
如果反过来先保存进度,再等待数据完成,程序中断后就可能留下“记录说完成,内容尚未写全”的组合。按正确顺序提交仍需考虑文件系统和平台的同步能力,包括目录项持久化;这些能力分别验证,断电恢复还需要相应的故障测试。
恢复时也不直接信任 JSON 里的完成标记。程序先检查任务参数与数据组织是否一致,再读回已提交分段,按原图样完整比较。若这部分内容已经损坏,任务失败并保留证据。自动重写损坏分段虽然能让后续比较通过,却会抹掉“已提交数据发生变化”的重要现象。
未提交分段则采用另一种处理。程序无法确定中断前究竟写到了哪里,因而完整重写该段,再重新提交。最后的全范围校验把前面复用与新写入的数据统一检查一次,使最终结果对应完整工作集。
这里还存在跨轮次的取舍。当前原生算法可以显式指定固定 generation,不同代次的完整单元可以区分,诊断也能报告代次不符;但一次计划的各轮仍使用同一代次,不会自动递增。同一位置、同一代次的旧内容仍能满足当前图样,因此当前结果继续保留 stale_write_detection=false。自动逐轮换代还需要协调 checkpoint、恢复与随机访问的期望内容,留在后续计划中。设备插拔产生的占用代次只用于目标绑定,与这个测试数据参数分别管理。
跨平台 I/O:把请求生命周期作为共同约束
平台各有合适的执行机制。Windows 可以用 IOCP 接收异步完成,Linux 与 Android AArch64 优先使用经过隔离探测的 io_uring,macOS 则通过 libdispatch worker 执行定位读写。PXDT3 把这些差异放在后端,核心统一关心请求何时提交、何时完成,以及缓冲区何时能够再次使用。
写入数据需要一直保留到系统确认完成;读取数据还要继续保留到比较结束。队列里的每个槽位负责承载这段生命周期。这样的结构让并发数量有上界,也让取消、短完成和失败有明确的资源回收路径。
flowchart TB A[空闲槽位] --> B[准备数据与偏移] B --> C[提交 I/O] C --> D[确认完成与长度] D --> E[读取时比较内容] E --> A
I/O 细节:Q/T、后端 worker、取消排空与缓存策略
在 PXDT3 中,Q 是每个提交线程的在途请求上限,T 是提交线程数。Q8T1 允许一个线程维持最多八个请求;Q32T16 的应用层上限是 512。这个定义落在应用请求层,便于跨平台比较,也允许调用方推算队列需要持有的缓冲区数量。
后端 worker 数量则描述另一个资源。IOCP 或 io_uring 可以由较少线程管理多个在途请求;执行同步调用的线程池,需要 worker 承接阻塞工作。应用提交线程、后端执行线程、内核排队请求和设备命令槽位有各自的约束,记录 Q/T 时还要保存后端类型及其执行配置。
Linux 的自动后端选择会在能力探测失败时使用有界线程池,并记录选择结果。这里变化的是执行机制。若任务要求严格缓存策略,后端切换仍需满足相同策略;无法满足时明确失败。运行过程中出现 I/O 错误,也不会悄悄换个后端继续,让原来的失败从结果中消失。
缓存又涉及多个层次。绕过操作系统页缓存的选项、数据同步、关闭后重开,以及设备自身的缓存,各自作用于不同位置。任务需要记录实际采用的方式。请求了严格模式而系统不支持时,只有明确选择允许 buffered,才可以按缓冲路径运行并保留该事实。
取消也需要分阶段处理:先停止继续提交,再请求取消支持取消的在途操作,最后等待完成并回收资源。Windows 对应 CancelIoEx 等路径,Linux 按能力使用异步取消;macOS 和线程池中已经开始的同步调用,通常仍要等待其返回。
因此,收到取消请求之后还可能出现一段排空时间。若驱动调用卡住,普通文件 API 无法给出固定的返回时限。核心必须保留停止中状态和仍存活的资源,工厂层再通过进程隔离维持控制面响应。把界面立即改成“已停止”,会让真实在途操作失去可见性。
短读与短写同样要进入完成处理。提交一个 1 MiB 请求,不代表已经完成 1 MiB;实际返回长度、错误码和取消状态决定这次请求能计入多少有效工作。校验只消费确实读回的内容,最终成功还需要满足完整范围与完成条件。
Android 的后端选择:先确认进程真正能用什么
Android 上,同一台设备的普通 Termux 进程与 root 进程,可能得到不同的 io_uring 结果。内核版本、编译配置、权限与 seccomp 系统调用过滤都会影响可用性。直接在主进程里试一次系统调用,还可能因 SIGSYS 让整个程序退出。
10 月 20 日接入的选择路径把探测放进独立地址空间,继承调用线程的凭据与安全策略。它实际检查 ring 创建、映射和 NOP,再在匿名内存文件上完成 4096 字节的 WRITEV、READV 与逐字节比较。探测不访问被测卷;文件系统的严格绕缓存能力继续单独检查。
| 选择方式 | 探测或运行结果 | PXDT3 的处理 |
|---|---|---|
auto | 明确的系统调用缺失或策略拒绝,包括 ENOSYS、EPERM、SIGSYS 等 | 记录原因,选择有界线程池 |
auto | 资源不足、比较失败、异常退出或探测超时 | 阻止启动,保留错误 |
显式 linux_io_uring | 原生后端不可用 | 拒绝执行,保持请求参数 |
显式 thread_pool | 使用线程池 | 跳过原生探测,按明确的 Q/T 与 worker 配置执行 |
| 任意后端已开始任务 | 队列初始化后的执行错误或文件 I/O 错误 | 保存失败并排空已接受请求 |
自动回退时,标准测速矩阵只运行 T1 的六个读写项目;额外选择的 Q32T16 留下跳过项和原因。单项任务如果在自动回退条件下要求 T>1,会在创建测试文件前拒绝;需要完整多线程压力时,可以显式选线程池。这样,操作者能从结果中知道哪些工况真正执行过。
AsyncCancel 的支持也单独探测。支持时可以请求取消;不支持时停止新提交,等待已接受请求排空。后端选择、缓存策略和取消能力分别记录,文件测试与 Benchmark 共用这套路径。
测速 先说明工况和计时
PXDT3 把完整性测试和独立测速分开:前者生成期望内容并完整比较;后者测量特定负载下的传输表现。分别记录它们的结果,读者才能知道一个速度数字包含多少计算工作。
当前提供三种测速模式。标准模式按固定传输量执行;参考 CrystalDiskMark 的 Time-based 模式按时间窗口采样;参考 AS SSD 的 Write-based 模式采用定量写入与相应的重复读取方法。它们共用 PXDT3 自己的数据生成、I/O 和统计实现。工具之间比较成绩时,需要对齐工作集、块大小、队列、线程、缓存和采样规则。CrystalDiskMark 官方说明也列出了工作集、控制器、CPU 与测试数据对成绩的影响。
我也希望让写入成本更清楚。1 GiB 工作集描述被反复访问的文件范围;在定时测试里,高速设备可以在这个范围上反复写入,累计写入远大于 1 GiB。因此,结果需要同时保留工作集与实际传输总量。
测速细节:三种默认工况、实际写入量与 CPU s/GB
用 S 表示实际工作集大小,当前默认模式有以下区别:
| 模式 | 默认项目 | 完成与采样方法 |
|---|---|---|
| Standard | 顺序 4 MiB Q4T1;4K Q1T1;4K Q32T1 | 每项每方向传输 S;一次采样,无预热与间隔 |
| Time-based | 顺序 1 MiB Q8T1 / Q1T1;4K Q32T1 / Q1T1 | 每项先预热 5 秒,再测三次、每次 5 秒,取最大吞吐;项目间隔 5 秒 |
| Write-based | 顺序 16 MiB Q1T1;4K Q1T1;4K Q1T64 | 每项写 S;单线程随机读 S;顺序与 64 线程读重复完整遍至至少 5 秒 |
Write-based 的顺序读取还会先舍弃一遍,项目之间间隔 1 秒。Q1T64 由 64 个同步提交线程各维持 Q1,所有线程共享总量 S;它与 Q64T1 的线程组织不同,即使应用层最大请求数相同,也不能省略这个差异。
Standard 与 Write-based 默认完整套件的首项顺序写兼作初始化,三个写项目累计应用层写入量为 3×S。若关闭首项顺序写、单独选择需要已有数据的项目,准备过程可能再增加一次完整工作集写入。这里统计的是程序通过文件 API 传输的量,设备内部写放大需要其他证据。
Time-based 的写入成本随吞吐增长。假设某个写窗口持续 5 秒,期间平均完成 2 GB/s,就会产生约 10 GB 的应用层写入;这只是计算示例,不是 PXDT3 的实测成绩。即便工作集只有 1 GiB,也能在同一范围循环很多次。准备和预热还会继续增加传输,因此报告保留工作集、计分样本和实际读写总量。
定时窗口结束后仍在完成的请求进入排空统计。定量模式则覆盖相应请求全部完成的时间。准备、预热与排空产生的传输也进入实际读写总量。
选择最大样本表达的是这组采样里观察到的最高吞吐。其他样本仍有价值:它们能显示预热之后是否继续变化,以及几次结果之间有多大差异。顶层展示的吞吐、CPU 与延迟来自同一个选中样本,避免把不同窗口的最好数字拼在一起。
计时还需要区分墙钟时间与 CPU 时间。多个提交线程共同完成一项工作,吞吐使用整个并发组的墙钟时间;进程 CPU 时间累计该进程消耗的计算资源。前者回答完成得多快,后者帮助观察主机为完成测试付出了多少计算。
吞吐之外,CPU s/GB 用进程 CPU 时间除以实际传输的十进制 GB,帮助观察每完成一份工作付出了多少计算成本。完整校验与纯测速应分别解释这个值。
工作集使用 GiB,1 GiB 为 2³⁰ 字节;吞吐里的 GB 使用十进制,1 GB 为十亿字节。统一单位后,还要对齐是否包含发生器、比较、队列初始化和同步。PXDT3 对应测速计时覆盖生成、提交和完成回收,最后的 flush 另报,纯测速的读取不做内容验证。
对 BurnInTest 固定样本的静态分析发现,其相关平均速度路径主要累计 I/O 调用用时,生成与比较位于计时区间之外。这类发现提醒我:比较前先统一分子与分母,再讨论性能差异。
Burn-in 把持续负载和最终复核连接起来
工厂需求还包含持续运行。一次短时测速之后,设备在反复读写中能否保持稳定,出错时能否保留有效记录,需要更长的测试流程。
PXDT3 参考 PassMark BurnInTest 的普通文件测试,提供顺序、随机寻址、高低频、AA、55、全零、全一、随机数据和用户模式九种模式,以及循环和预设。Cyclic 负责轮换这些模式,数据生成与读回比较仍由各自的规则定义。
其中,随机压力之后的完整复核很重要。随机访问会重复命中某些位置,也可能始终没有访问另一些位置。PXDT3 的相关流程先初始化并校验工作集,在随机阶段执行带比较的请求,结束后同步、重开,再完整复核已初始化范围。累计访问量和最终覆盖量分别记录,结果能够说明实际检查到了哪里。
Burn-in 细节:模式、文件循环、随机覆盖和最终完成条件
九种模式改变的维度并不完全相同。AA、55、全零和全一强调特定字节图样;用户模式使用指定的 64 位内容;随机数据改变内容;随机寻址改变访问顺序。Cyclic 负责按计划轮换模式,它本身没有新增一种发生器。
高低频模式的步骤也需要明确。当前实现先写 AA,再写重复的 08 42 10 84 21 图样,之后读回比较。这里两次写入构成一个模式流程。如果只拿模式次数乘以文件大小计算写入量,就会漏掉其中一遍。模式次数、文件循环、实际传输量各有独立含义。
随机数据参考经典工具的方法,但 PXDT3 的种子与分块规则有自己的定义。复用模式名称有助于理解负载类型,逐字节兼容则需要完全一致的发生器和状态推进。前面针对 H2testw、URWtest 所做的原版发生器验证,与这里的方法参考分别记录。
文件大小与循环次数也容易混在一起。以卷容量的 1% 设置文件段、执行 100 个文件循环,或者 10% 执行 10 个循环,描述的是逻辑测试配方。文件系统如何分配这些文件、设备如何映射逻辑地址、Cyclic 实际完成了哪些模式,需要相应记录;名义百分比相乘无法给出介质物理地址的唯一覆盖。
verified-soak 的流程先完整初始化并校验工作集,再运行带比较的随机压力,最后同步、重开并完整复核。随机阶段避免同时在途的请求覆盖相互冲突的范围,让读请求的期望内容保持明确。压力阶段每一次有效读取都能检查内容,最终扫描再检查随机阶段没有访问到的位置。
例如,一个范围被随机读取十次,累计读取量会增加十次,唯一覆盖范围仍然只有这一份。某些位置恰好从未命中,却在压力期间发生内容变化,最终扫描才有机会把它们找出来。因此,随机访问量描述负载强度,完整扫描描述最后检查到的范围,两者共同构成结果。
停止条件同样属于配方。定时阶段需要确实完成有效操作;截止时间、主动取消、I/O 错误和校验失败分别进入相应状态。若随机压力已经结束,但最终复核尚未完成,整个验证流程仍有未完成工作。已发现的错误会锁存,后续某一步成功不会把之前的失败覆盖成通过。
架构分层:从测试核心到 Workbench 与 Node
第三代继续保留可嵌入方向。我把“怎样测试一个目标”“怎样观察设备”“怎样让其他语言调用”和“怎样管理一组工位”分别放到合适的层。原先设计里的 Factory App、Factory Backend 和 Factory Daemon,如今分别落在 Workbench、Orchestrator 和 Node 中。桌面、终端和远程入口复用同一套测试与设备事实。
这些层通过不同路径使用同一个核心。Rust CLI 和受监督的独立 worker 直接调用 Core,C、C++、Python 等宿主通过 FFI 调用。Core 负责文件 I/O 与完成判定,Device 负责目录、设备、健康与拓扑观测,Orchestrator 负责批次、资源准入、工位与归档。Workbench 把这些能力组织成操作者可以使用的界面。
| 层次 | 拥有的职责 | 当前阶段 |
|---|---|---|
Core:pxdt-core | 计划预检、图样、文件 I/O、完整比较、测速与 Burn-in 编排、进度、取消、原始结果 | 已实现,按功能与平台持续验证 |
FFI:pxdt-ffi | C ABI、跨语言句柄、输入输出缓冲区、错误与 panic 边界 | 已实现,配套头文件与消费示例 |
CLI / TUI:pxdt-cli | 命令行参数、交互表单、计划预览、进度与结果展示、JSONL 和结果导出 | 已实现;TUI 是 CLI 的交互呈现方式 |
Device:pxdt-device | 只读设备与卷关联、SMART、拓扑与盘位观测,保留来源和覆盖范围 | 已实现共享接口与平台采集入口,具体硬件组合分别验收 |
Orchestrator:pxdt-orchestrator | 批次、准入、worker 监督、工位校准、定位租约与归档 | 已实现本机编排及相关软件合同,产线策略继续推进 |
GUI:pxdt-workbench | 参数与预检、目标网格、节点和配置管理、图表与结果浏览 | macOS、Windows、Linux 共用桌面入口已接入;VM/容器图形与原生系统验收分别推进 |
Node:pxdt-node | 无界面宿主、发现、RPC、可选角色认证、幂等回执和状态订阅 | 已实现;跨机器及 Windows/Linux 原生运行待验收 |
i18n:pxdt-i18n | 共享语言选择、结构化诊断和人类可读消息 | 已统一使用 rust-i18n,归档诊断可按显示语言重新渲染 |
Core 关心一项计划是否完成、内容是否正确;Orchestrator 关心这项计划属于哪个目标和批次、何时允许启动、结果怎样与健康及工位记录关联。Node 让同一后端在没有桌面窗口时持续运行。Workbench 中的“运行结束”、Core 的内容结论、设备健康和编排状态各有自己的依据。
选择 Rust,主要是希望把缓冲区所有权和跨线程约束表达得更直接。旧项目中需要靠约定维持的生命周期,在新核心里尽量交给类型和清晰的请求状态管理。操作系统 I/O 与 FFI 仍需单独检查,尤其是取消、短完成和错误回收。
Core 设计:统一任务入口、内部 FileSession 与上层编排
调用方通过 TaskPlan / TaskHandle 等统一任务入口准备和执行工作。准备阶段解析参数、检查范围与能力,给出实际计划;执行阶段负责进度、取消、等待和结果。C ABI 与 JSON 接入同一套 Core 预检,减少不同入口对同一个参数给出不同解释的机会。
内部 FileSession 管理测试工作集、文件和步骤执行所需的状态。它允许一个活动步骤在内部维持有界并发,并在步骤之间复用工作集。发生器、比较器和队列继续各自负责数据定义、内容检查和请求完成。这是内部实现结构,外部 SDK 的稳定入口保持在任务层。
Benchmark 与 Burn-in 的编排也在 Core:前者定义测试项目、采样与间隔,后者定义模式、循环与复核条件。若把这些逻辑分别写进 CLI、WPF 或 Workbench,每个入口都要重复处理准备、取消与失败传播。放回 Core 后,界面主要负责输入与呈现,同一个任务能通过不同入口得到一致的完成语义。
文件测试引擎操作指定挂载目录中的自建普通文件。公开 Core 产品同时提供独立的 Device 只读观测模块,由 CLI、SDK 和 Workbench 共用;分区、格式化与产线策略继续留在上层。这延续了第二代的职责分工,也让只需要文件校验的调用方能够单独使用引擎。
工厂层负责把单目标能力放进多目标环境,包括批次、配方、资源准入、设备健康和结果归档。它保留 Core 的原始步骤结果,再结合型号门槛和现场条件形成工厂判定。某项必需的健康数据缺失时,结果需要保留缺失状态;某项 Core 测试失败时,上层也保留原始失败。
当前独立 worker 已直接调用同一 Core,在进程内部执行逐块 I/O,外层只传计划、进度与结果。异常 worker 的监督、取消与归档由 Orchestrator 处理;驱动卡死、热插拔以及共享控制器故障的影响,仍需按实际平台和治具验证。
FFI 与 CLI/TUI:调用边界、结果所有权和真实终端渲染
FFI 将 Rust Core 包装成 C ABI。它使用不透明任务句柄和固定宽度字段,输入 JSON 以带长度的 UTF-8 传入,Core 在接收时复制需要的数据;输出采用调用方提供的缓冲区,先查询所需容量,再读取完整内容。这样,跨语言调用者可以明确知道内存由谁分配、何时有效、由谁释放。
这个边界同时负责参数检查和 panic 转换。正常的测试失败以结构化结果保留,接口调用错误通过相应状态返回。调用者依然需要遵守有效指针和句柄生命周期:任务结束与句柄释放分开,运行时取消后等待排空,释放成功后停止访问。头文件与运行库按同一交付使用,避免把布局差异误读成运行数据。
CLI 负责把参数、容量单位和交互输入转成统一计划,再观察任务。TUI 使用相同的 CLI 和 Core 能力,增加表单、实时进度、图表与结果页面。批处理可以选择普通文本或 JSONL;终端操作者可以使用 TUI。测速项目的调度、Burn-in 的模式循环和最终判定仍在 Core,界面只呈现这些事实。
下面的关系中,实线表示当前已有调用路径:
flowchart TB CLI[CLI / TUI] --> CORE[pxdt-core] HOST[C / C++ / Python 宿主] --> FFI[C ABI / pxdt-ffi] FFI --> CORE CORE --> IO[普通文件 I/O 与校验]
界面可以独立于存储任务预览。preview 入口在内存中构造测试状态,交给真实的 TUI 渲染器,目标显示为 SIMULATED,标题标注“界面演示”。它不启动存储测试,适合观察布局或截图;画面中的模拟进度也不作为设备性能成绩。
sh
pxdt preview --output tui --lang zh-Hans --duration-ms 30000这条命令保持演示 30 秒,按 Q、Esc 或 Ctrl+C 可以提前退出。当前预览时长允许 250–30000 毫秒。预览使用现有界面代码,因而字体、终端尺寸、换行和窄屏布局都能在真实终端中观察。
TUI 实际界面:从计划到结果
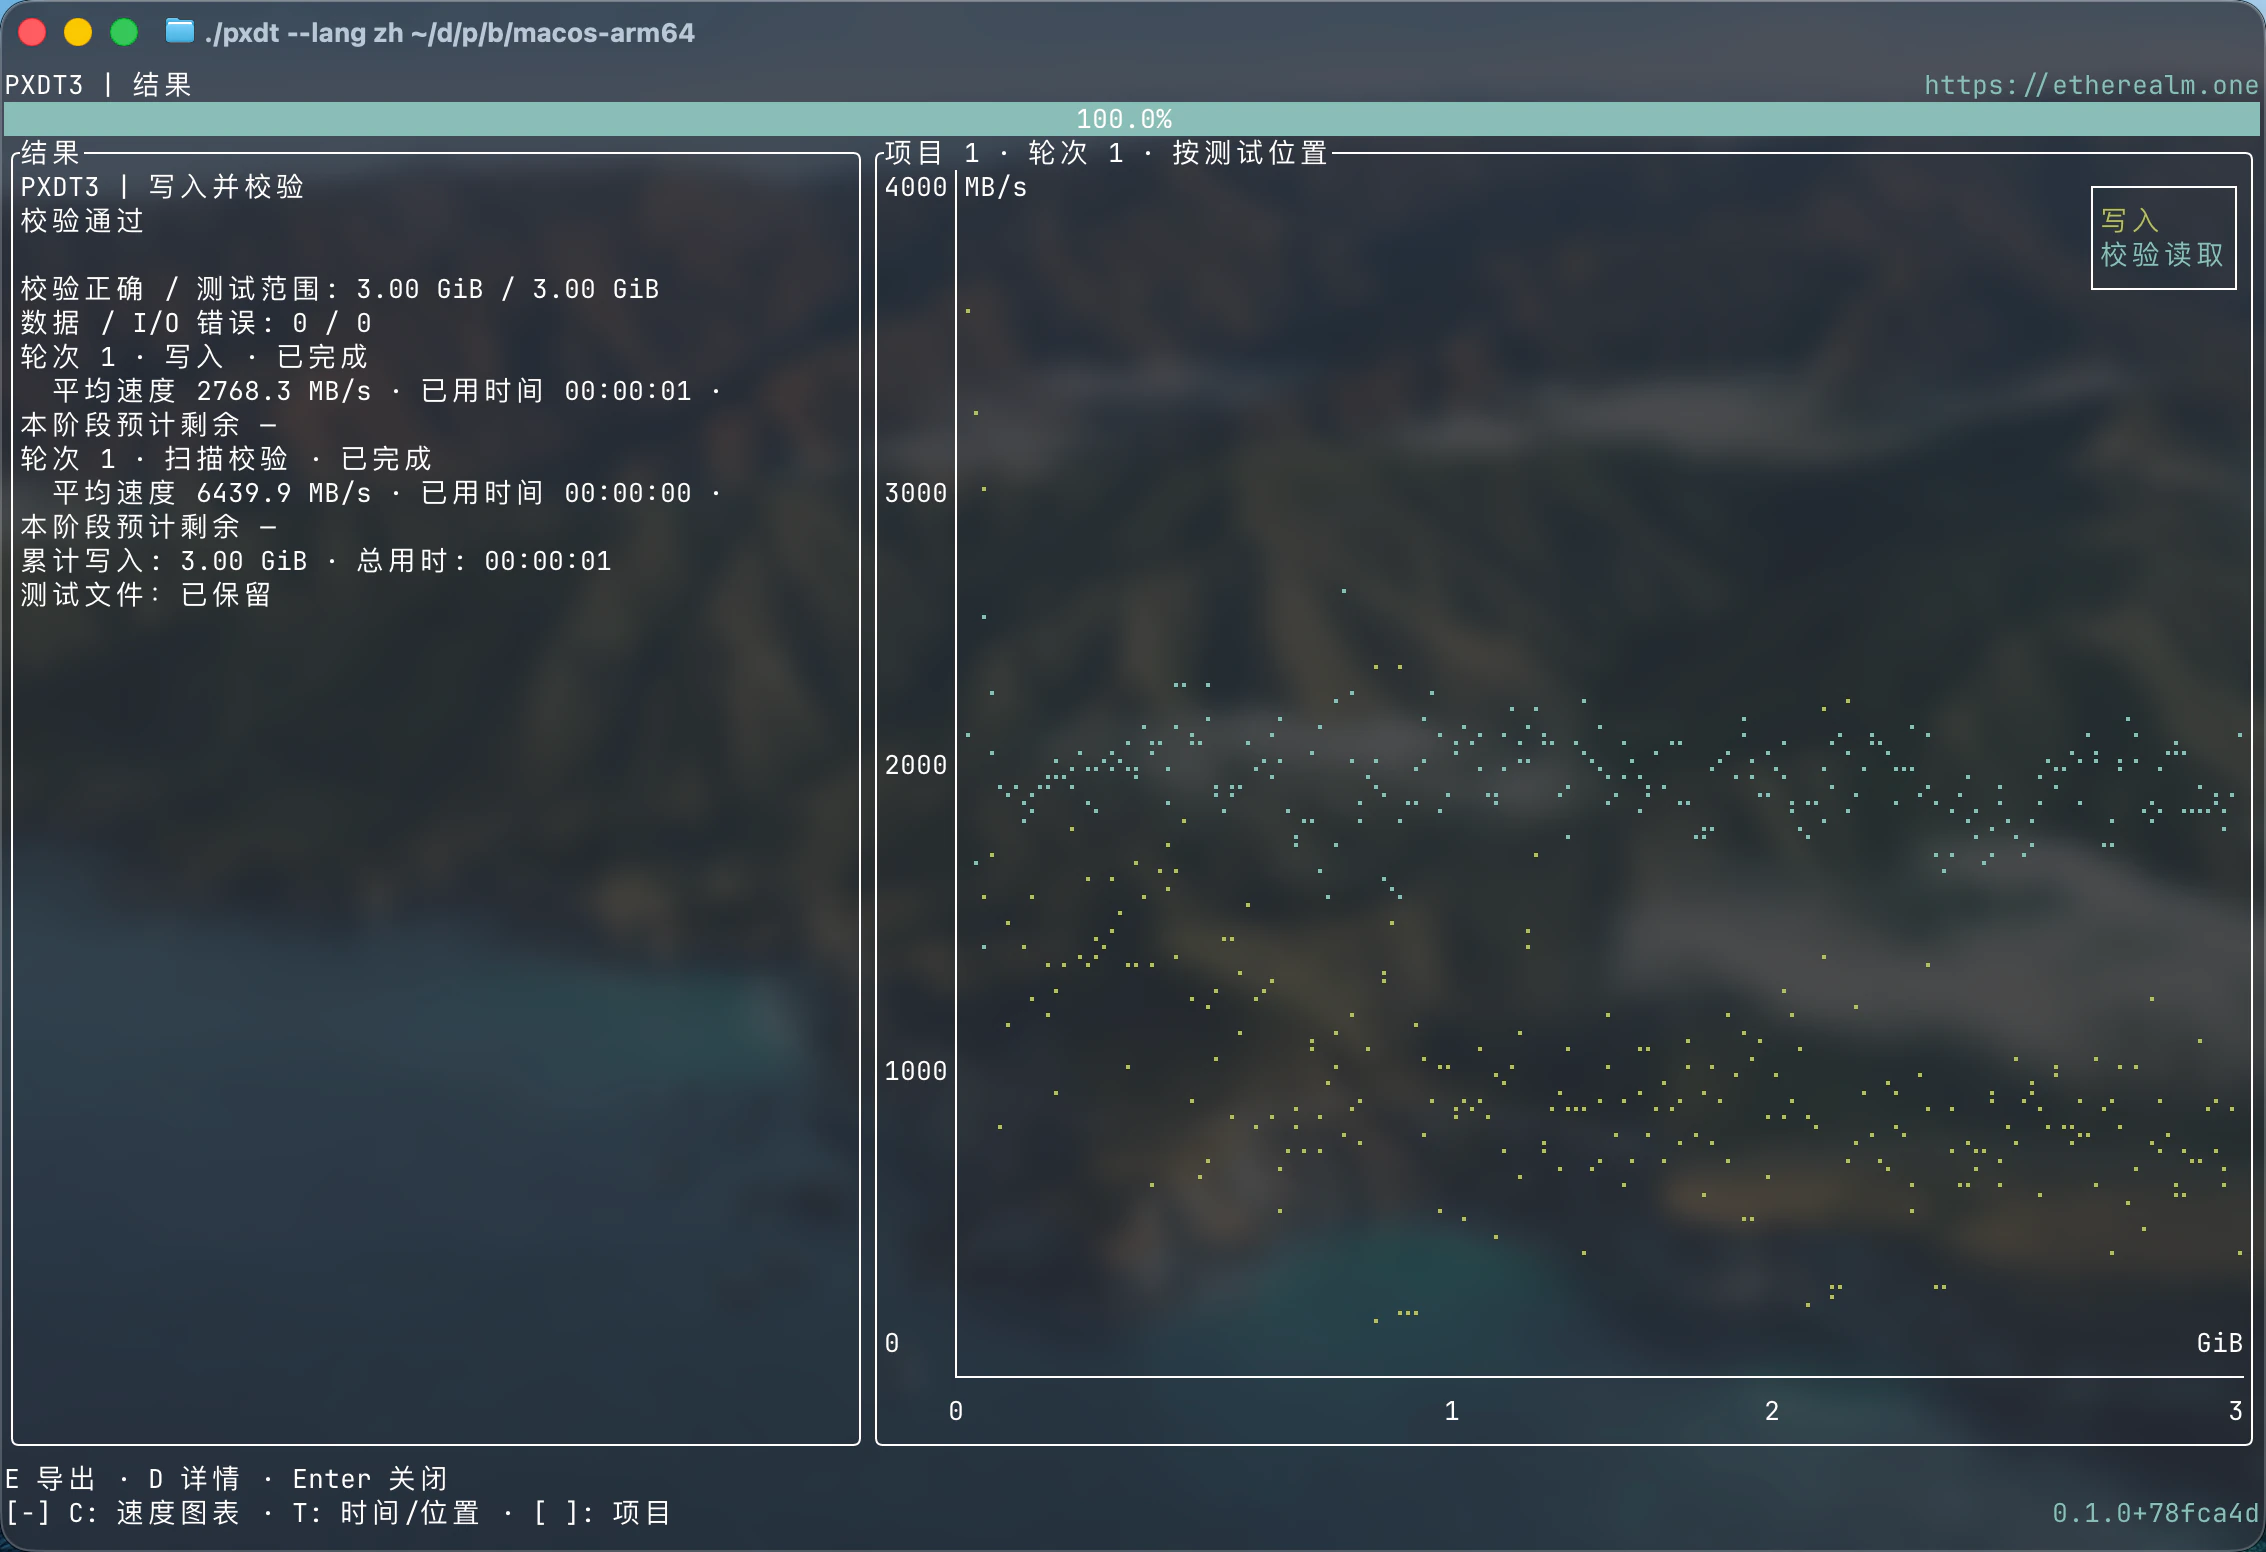
下面保留 2026 年 10 月 14 日的 macOS 终端截图,界面版本为 0.1.0+78fca4d,展示当时测速与写入校验的操作过程。图中数字保留当时的界面状态,用来说明 TUI 的交互与结果组织;当前 Workbench 界面另见后文。
设置页把常用参数放在左侧,把解析后的测试位置、工作集和项目放在右侧。更多测试与高级参数按需展开,底部保留直接可见的开始入口。
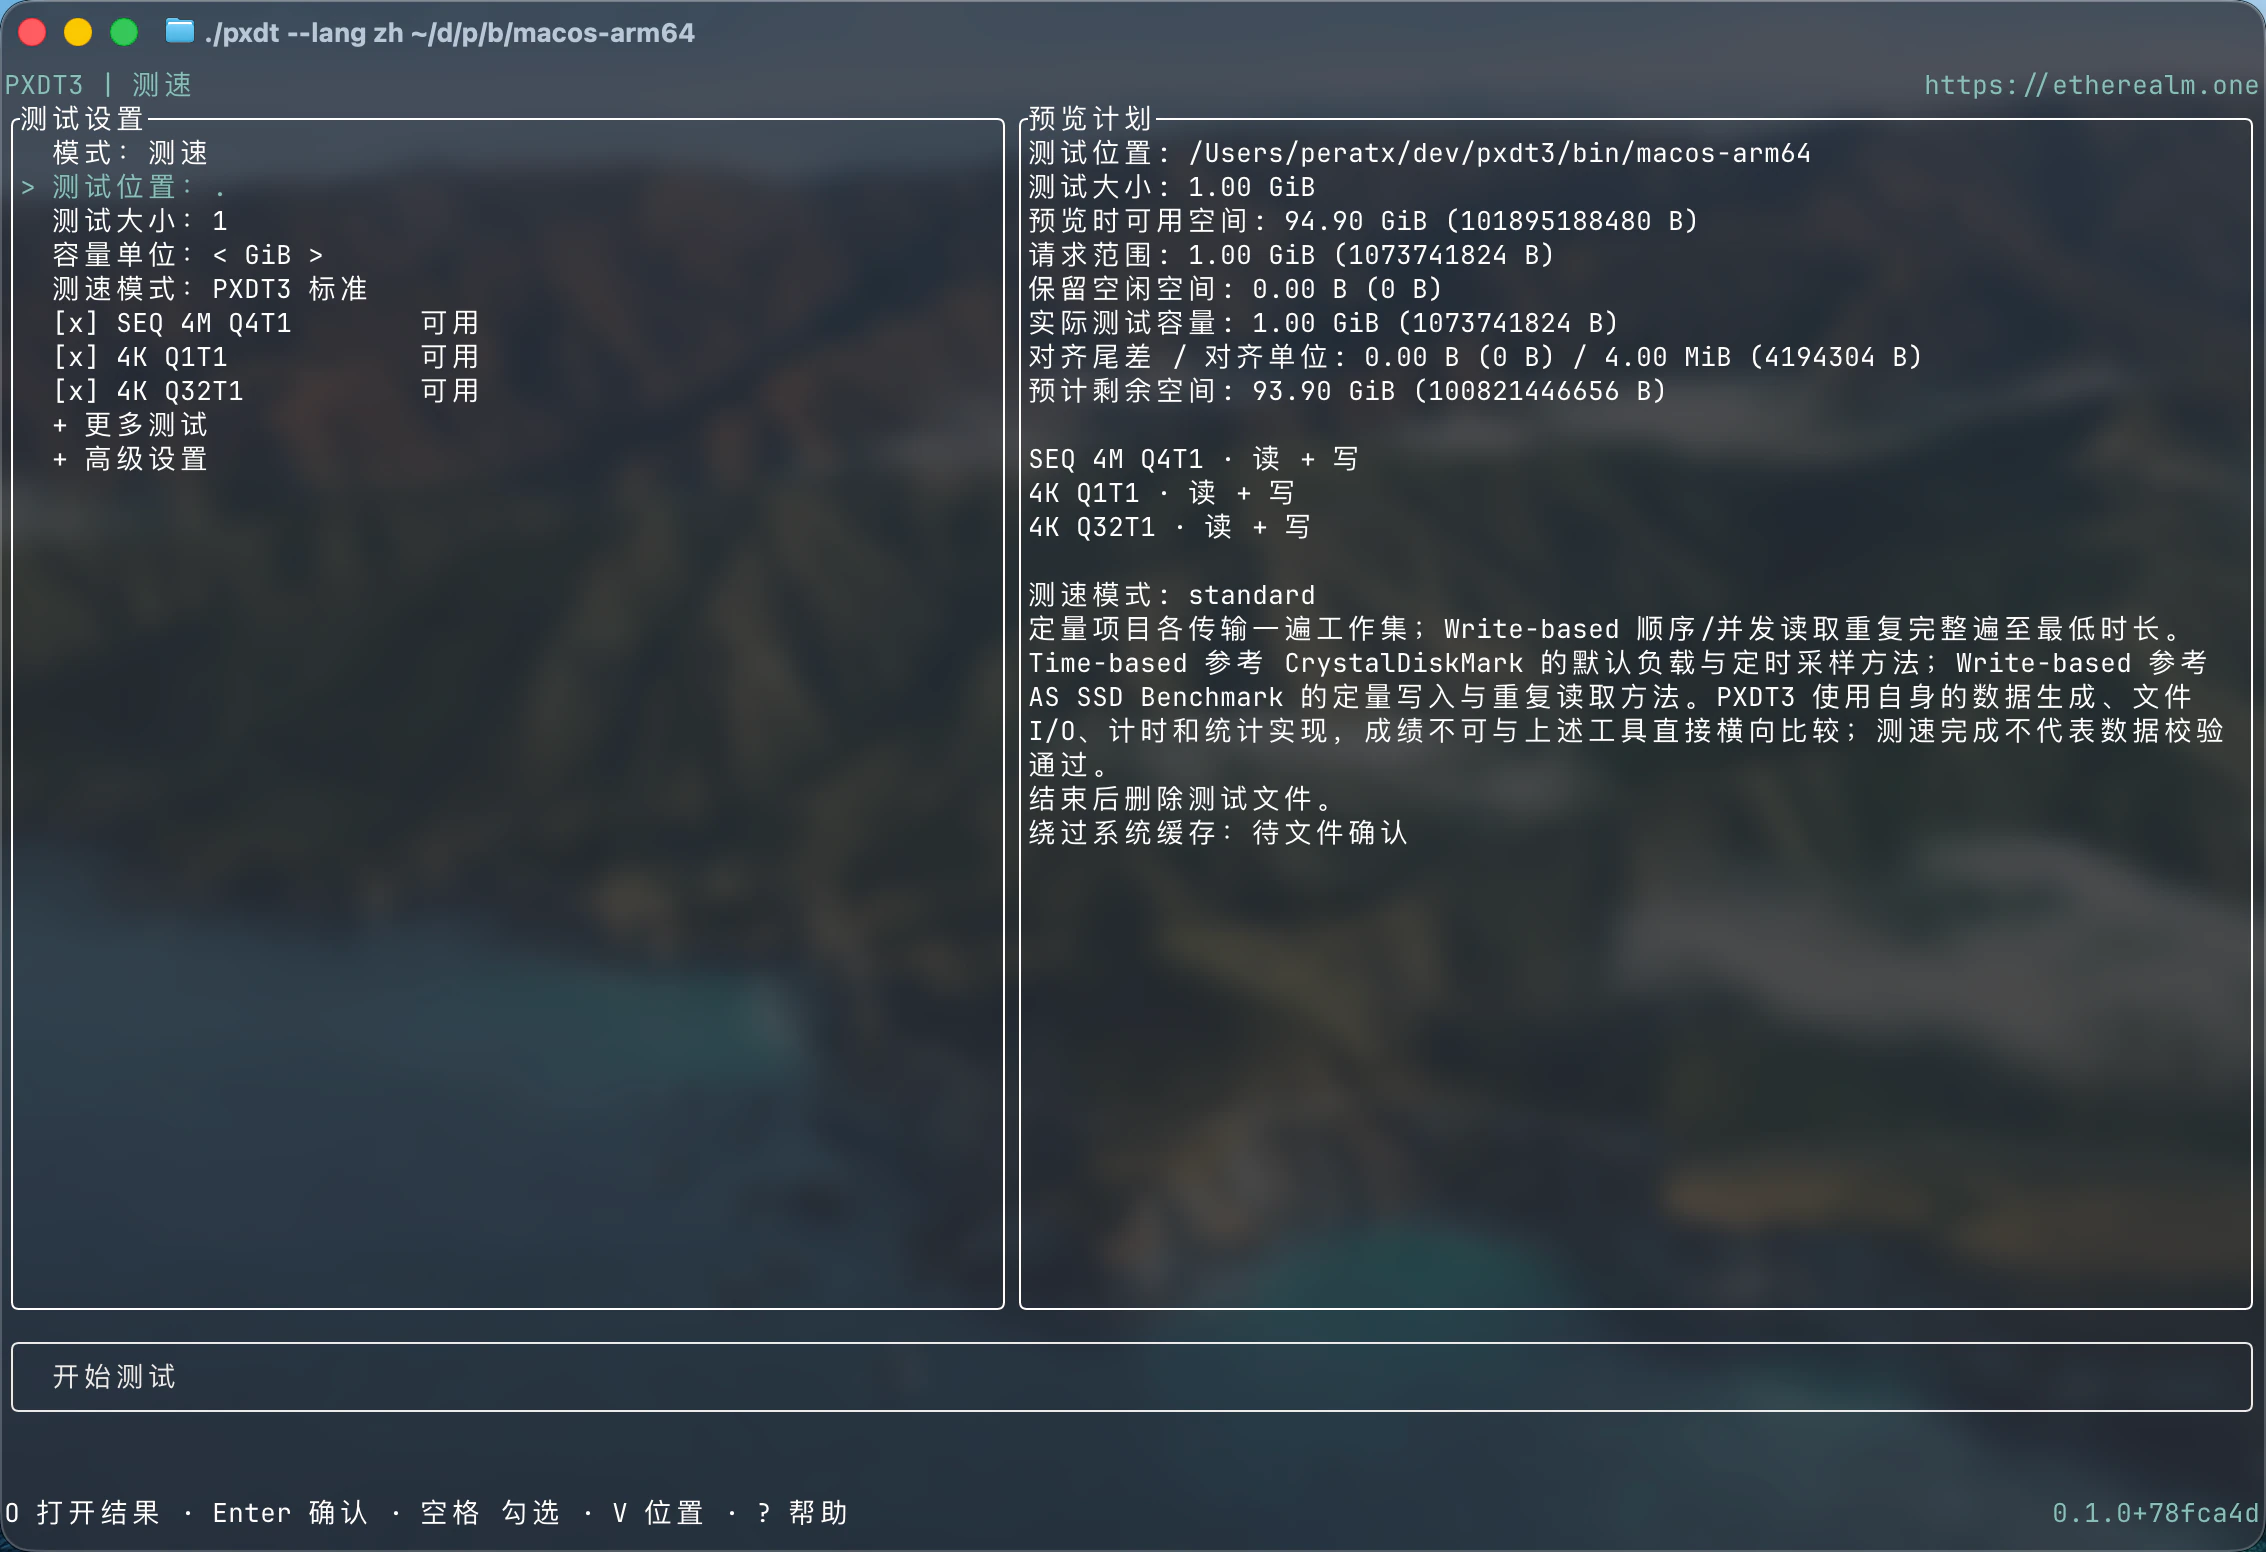
设置与开始:更多项目、高级参数和最终确认
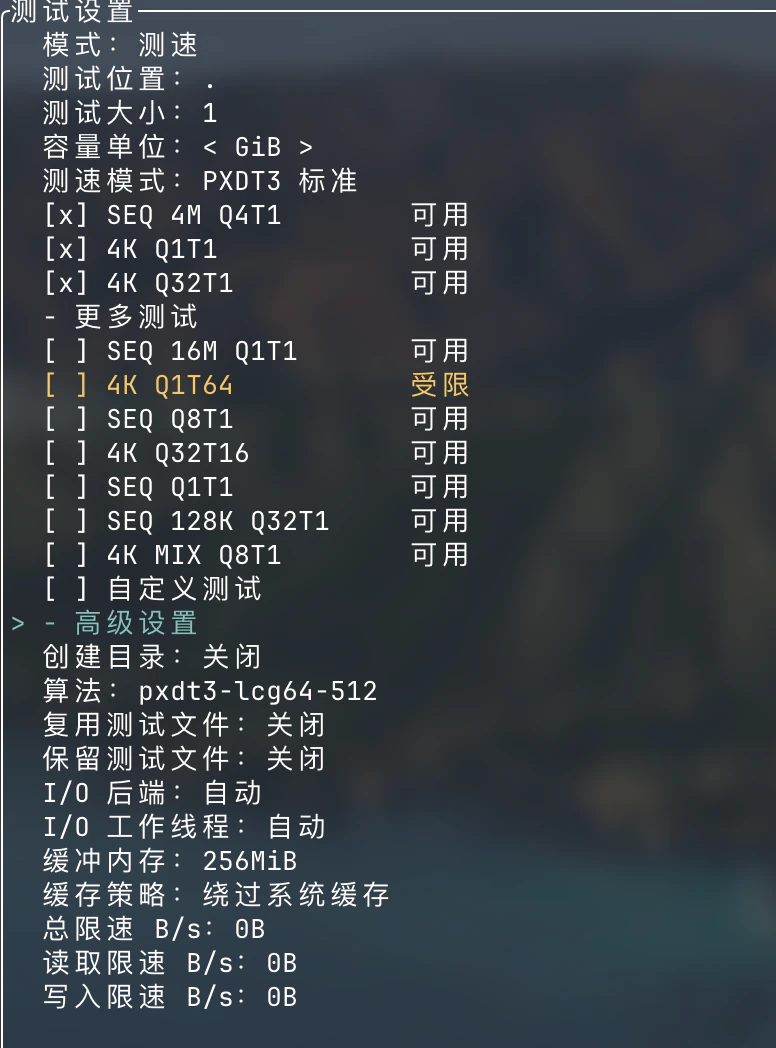
展开后可以选择其他负载,查看项目是否可用,并配置 I/O 后端、工作线程、缓冲内存、缓存策略和限速。常用入口保持简短,具体能力与限制在需要时出现。
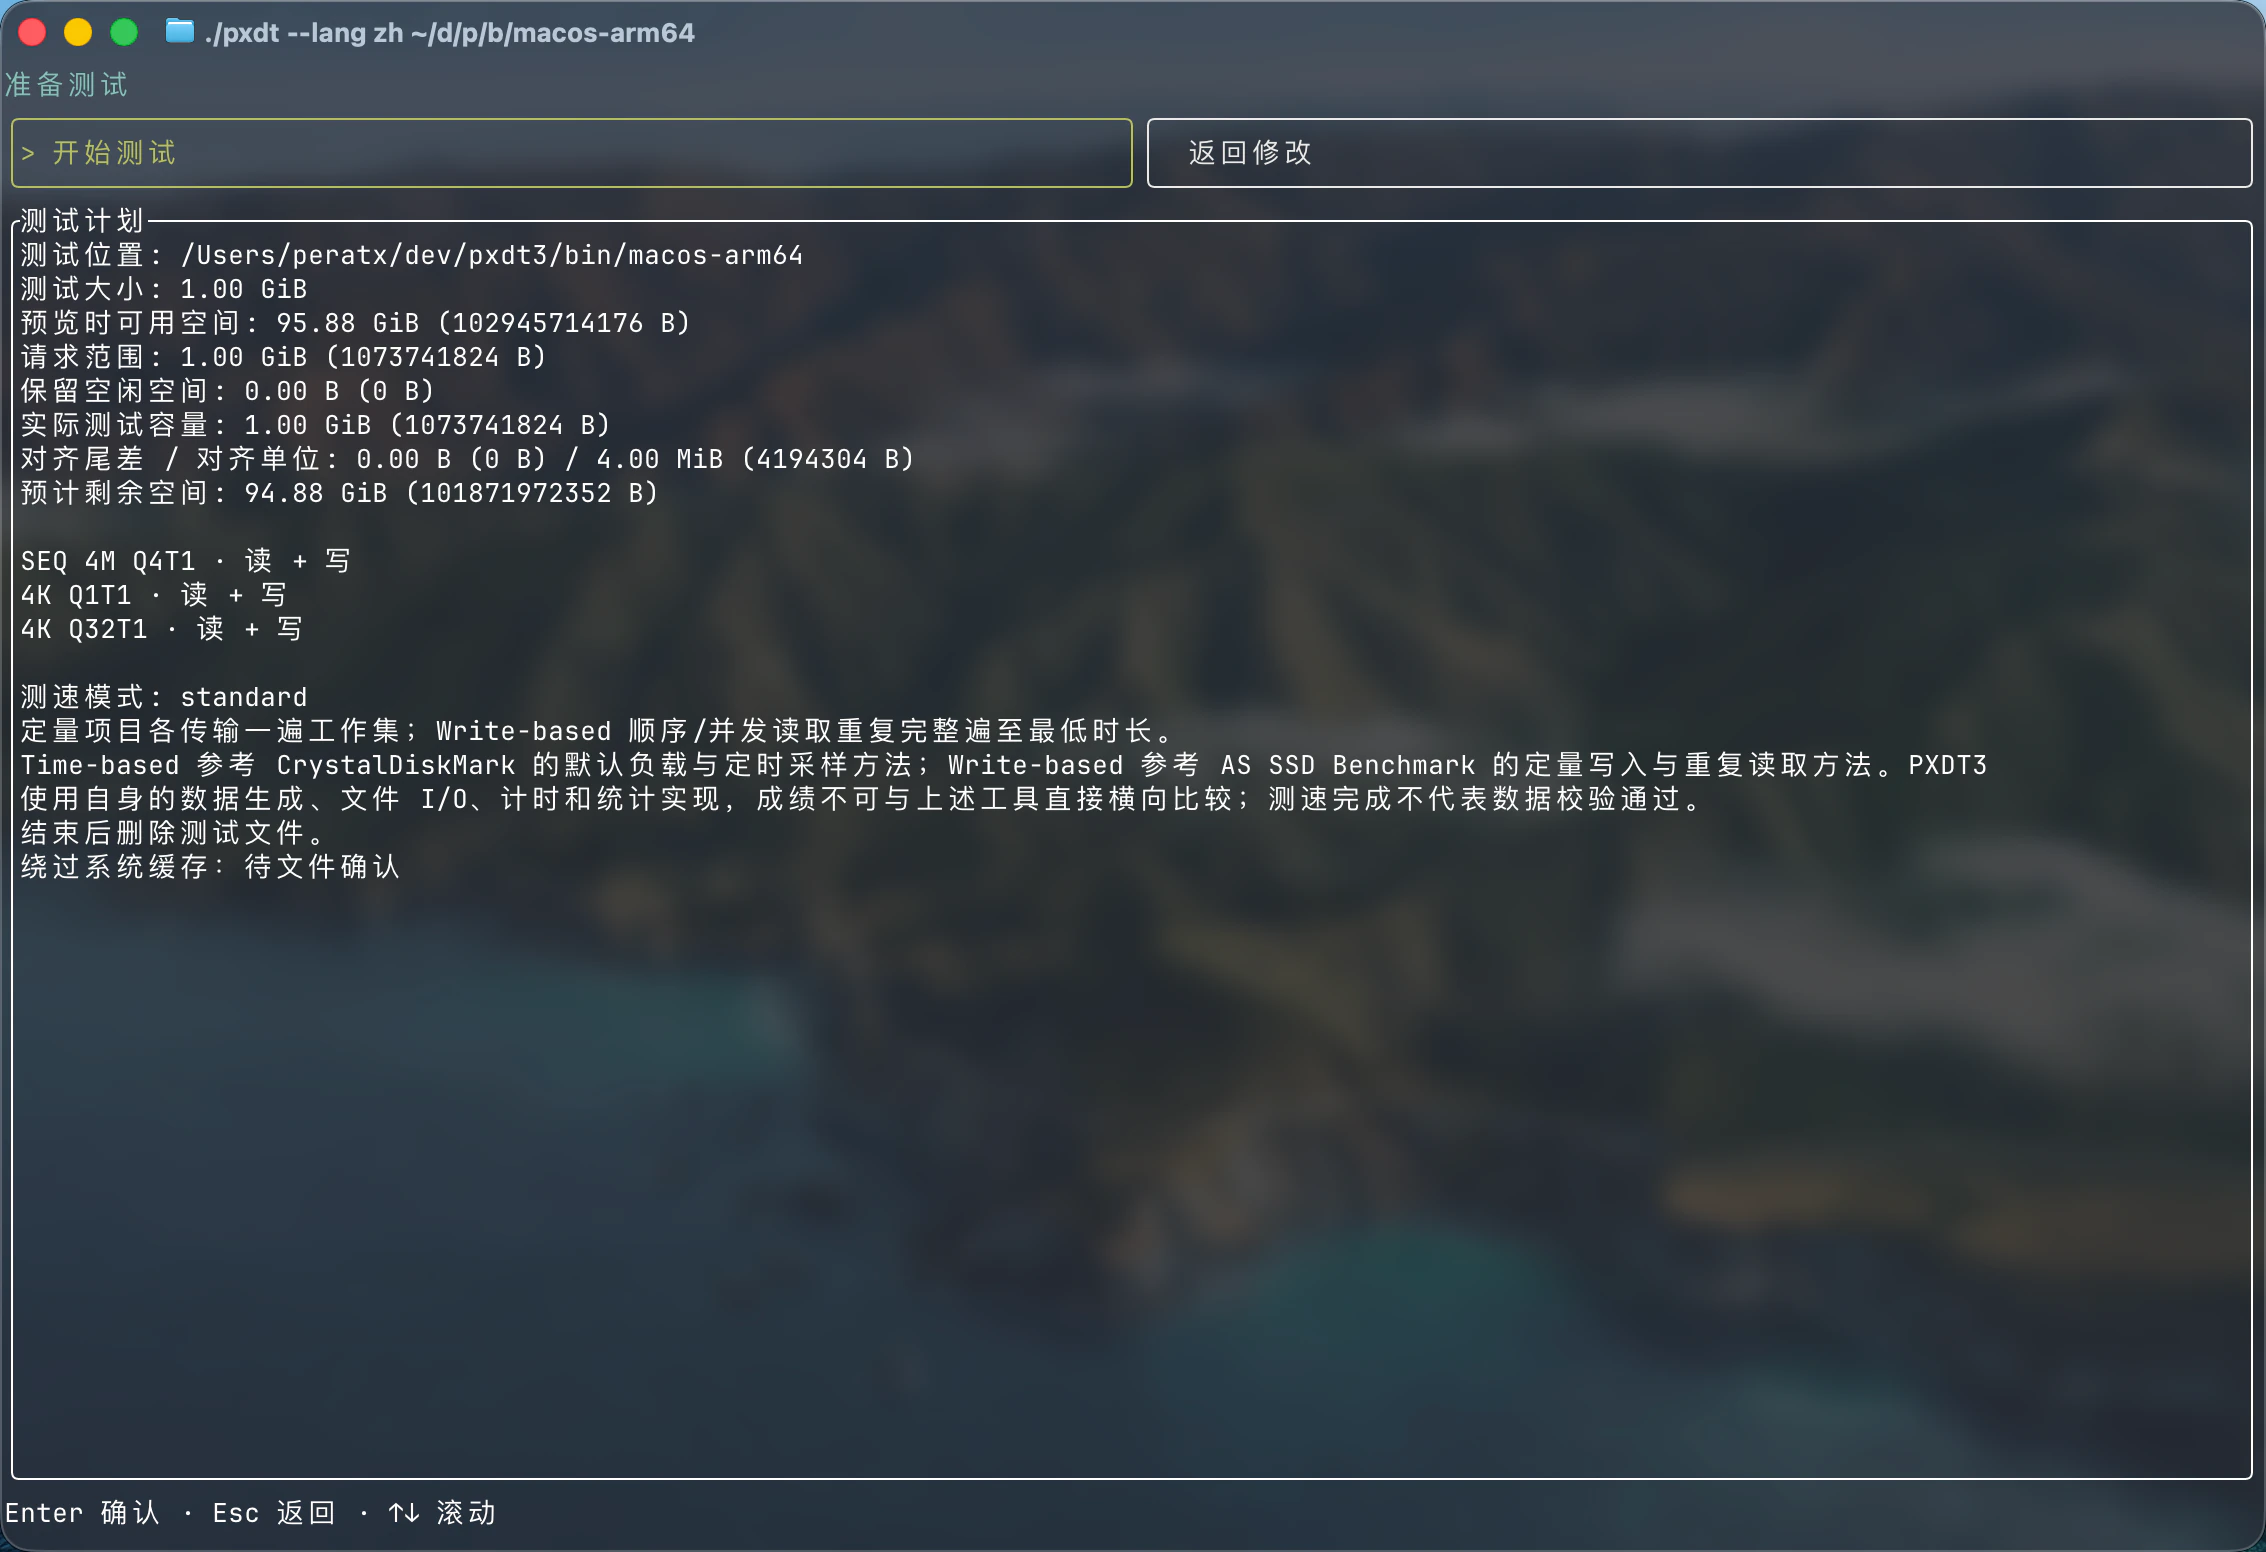
开始前再展示一次实际计划,操作者可以确认执行,也可以返回修改。这里的容量包含对齐与预留空间处理后的结果。
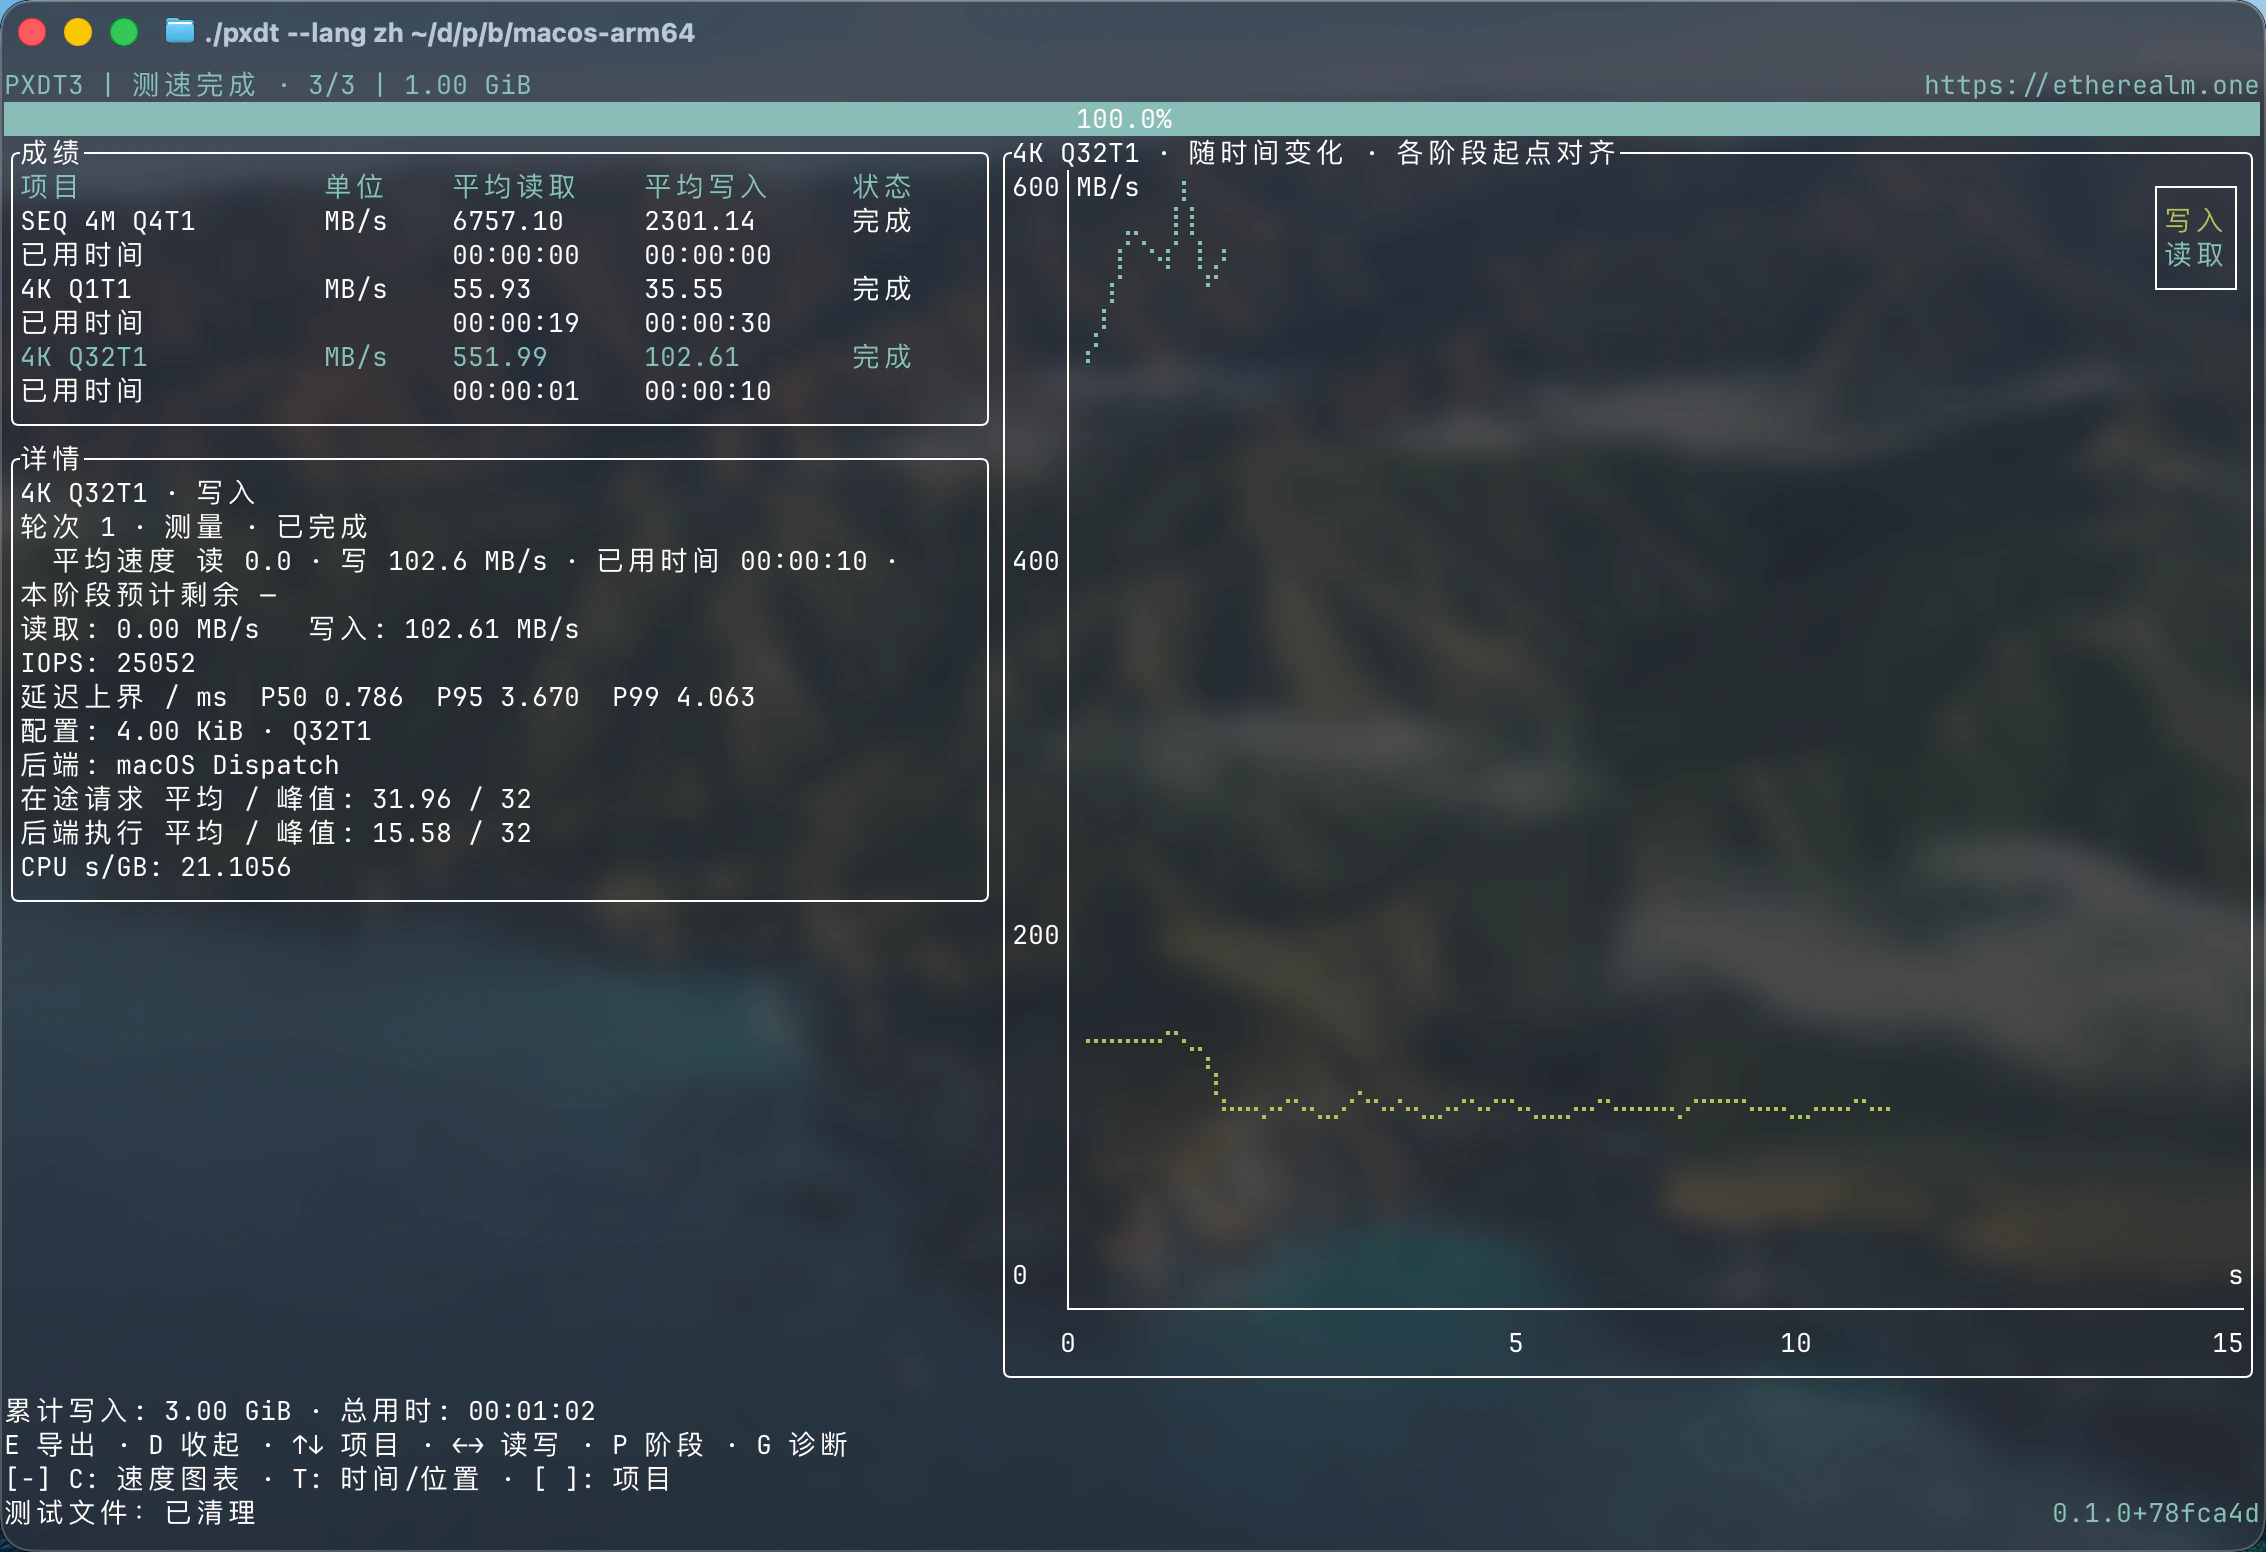
运行结束后,成绩表保留各项目的读写速度与耗时;选中项目可以查看 IOPS、延迟分位数、后端及队列观测。图表和详细信息分别按需展开,让终端既能快速读成绩,也能继续查看执行细节。
运行过程:简洁进度与实时速度图表
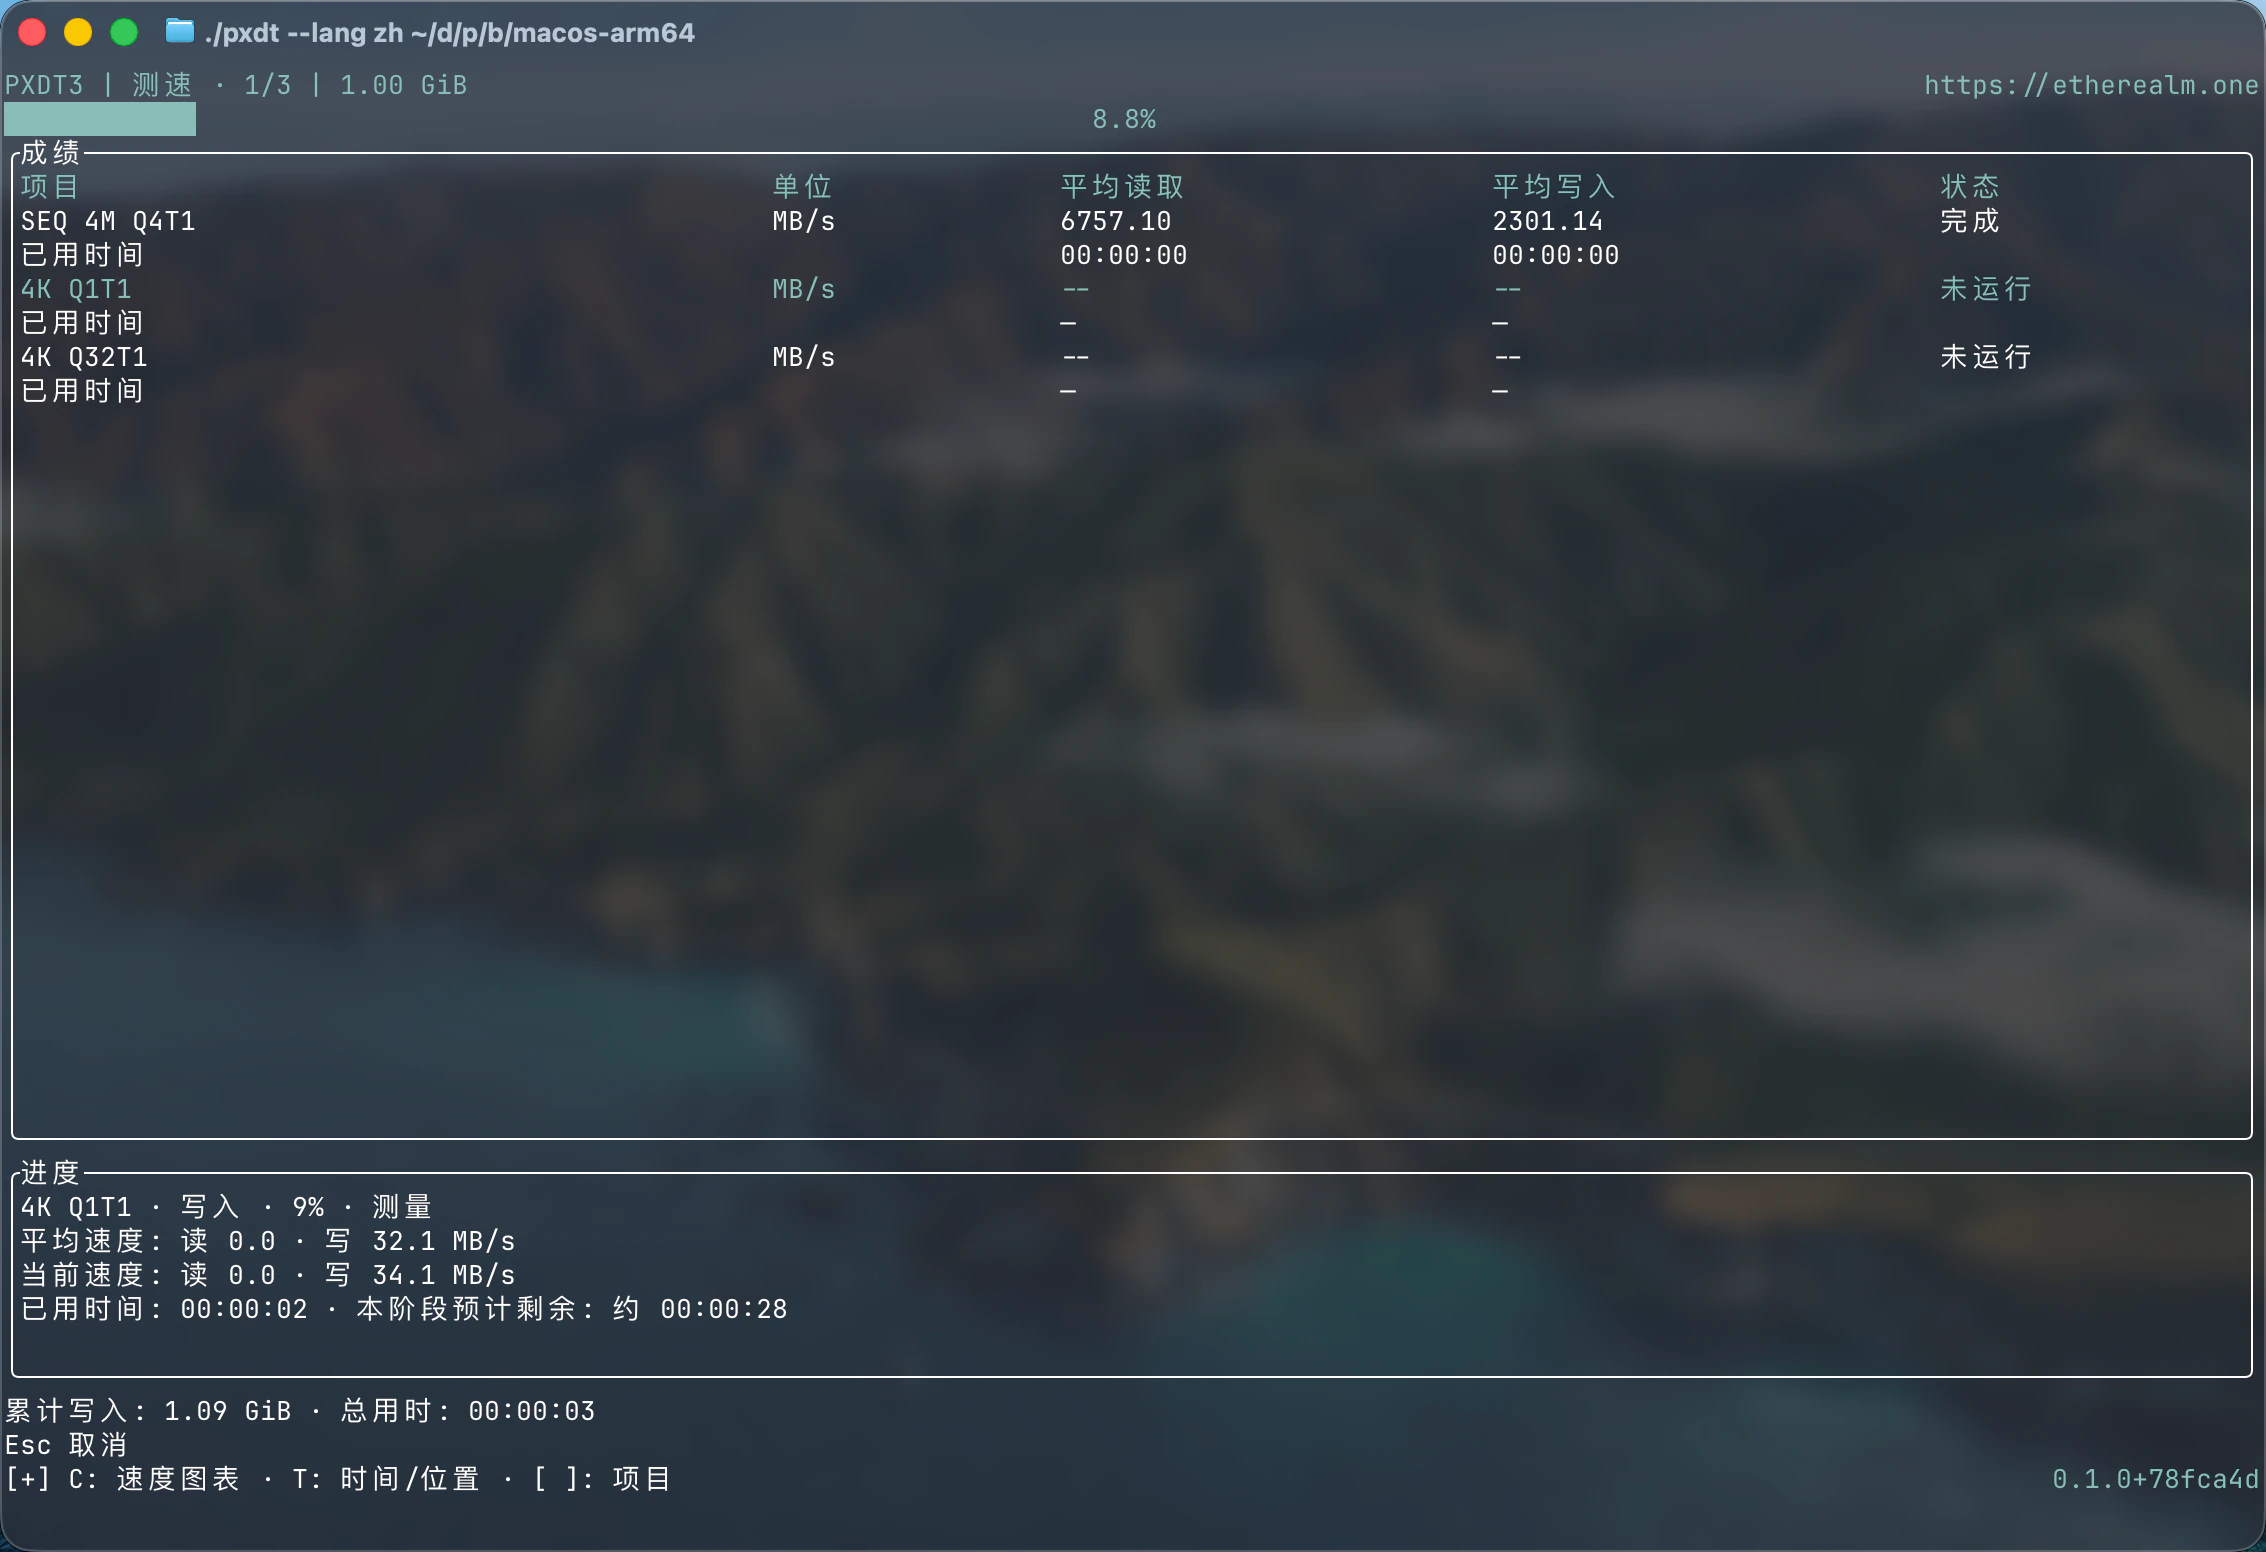
关闭图表时,主要区域显示项目成绩,当前阶段显示在下方,包括读写方向、平均速度、当前速度与预计剩余时间。
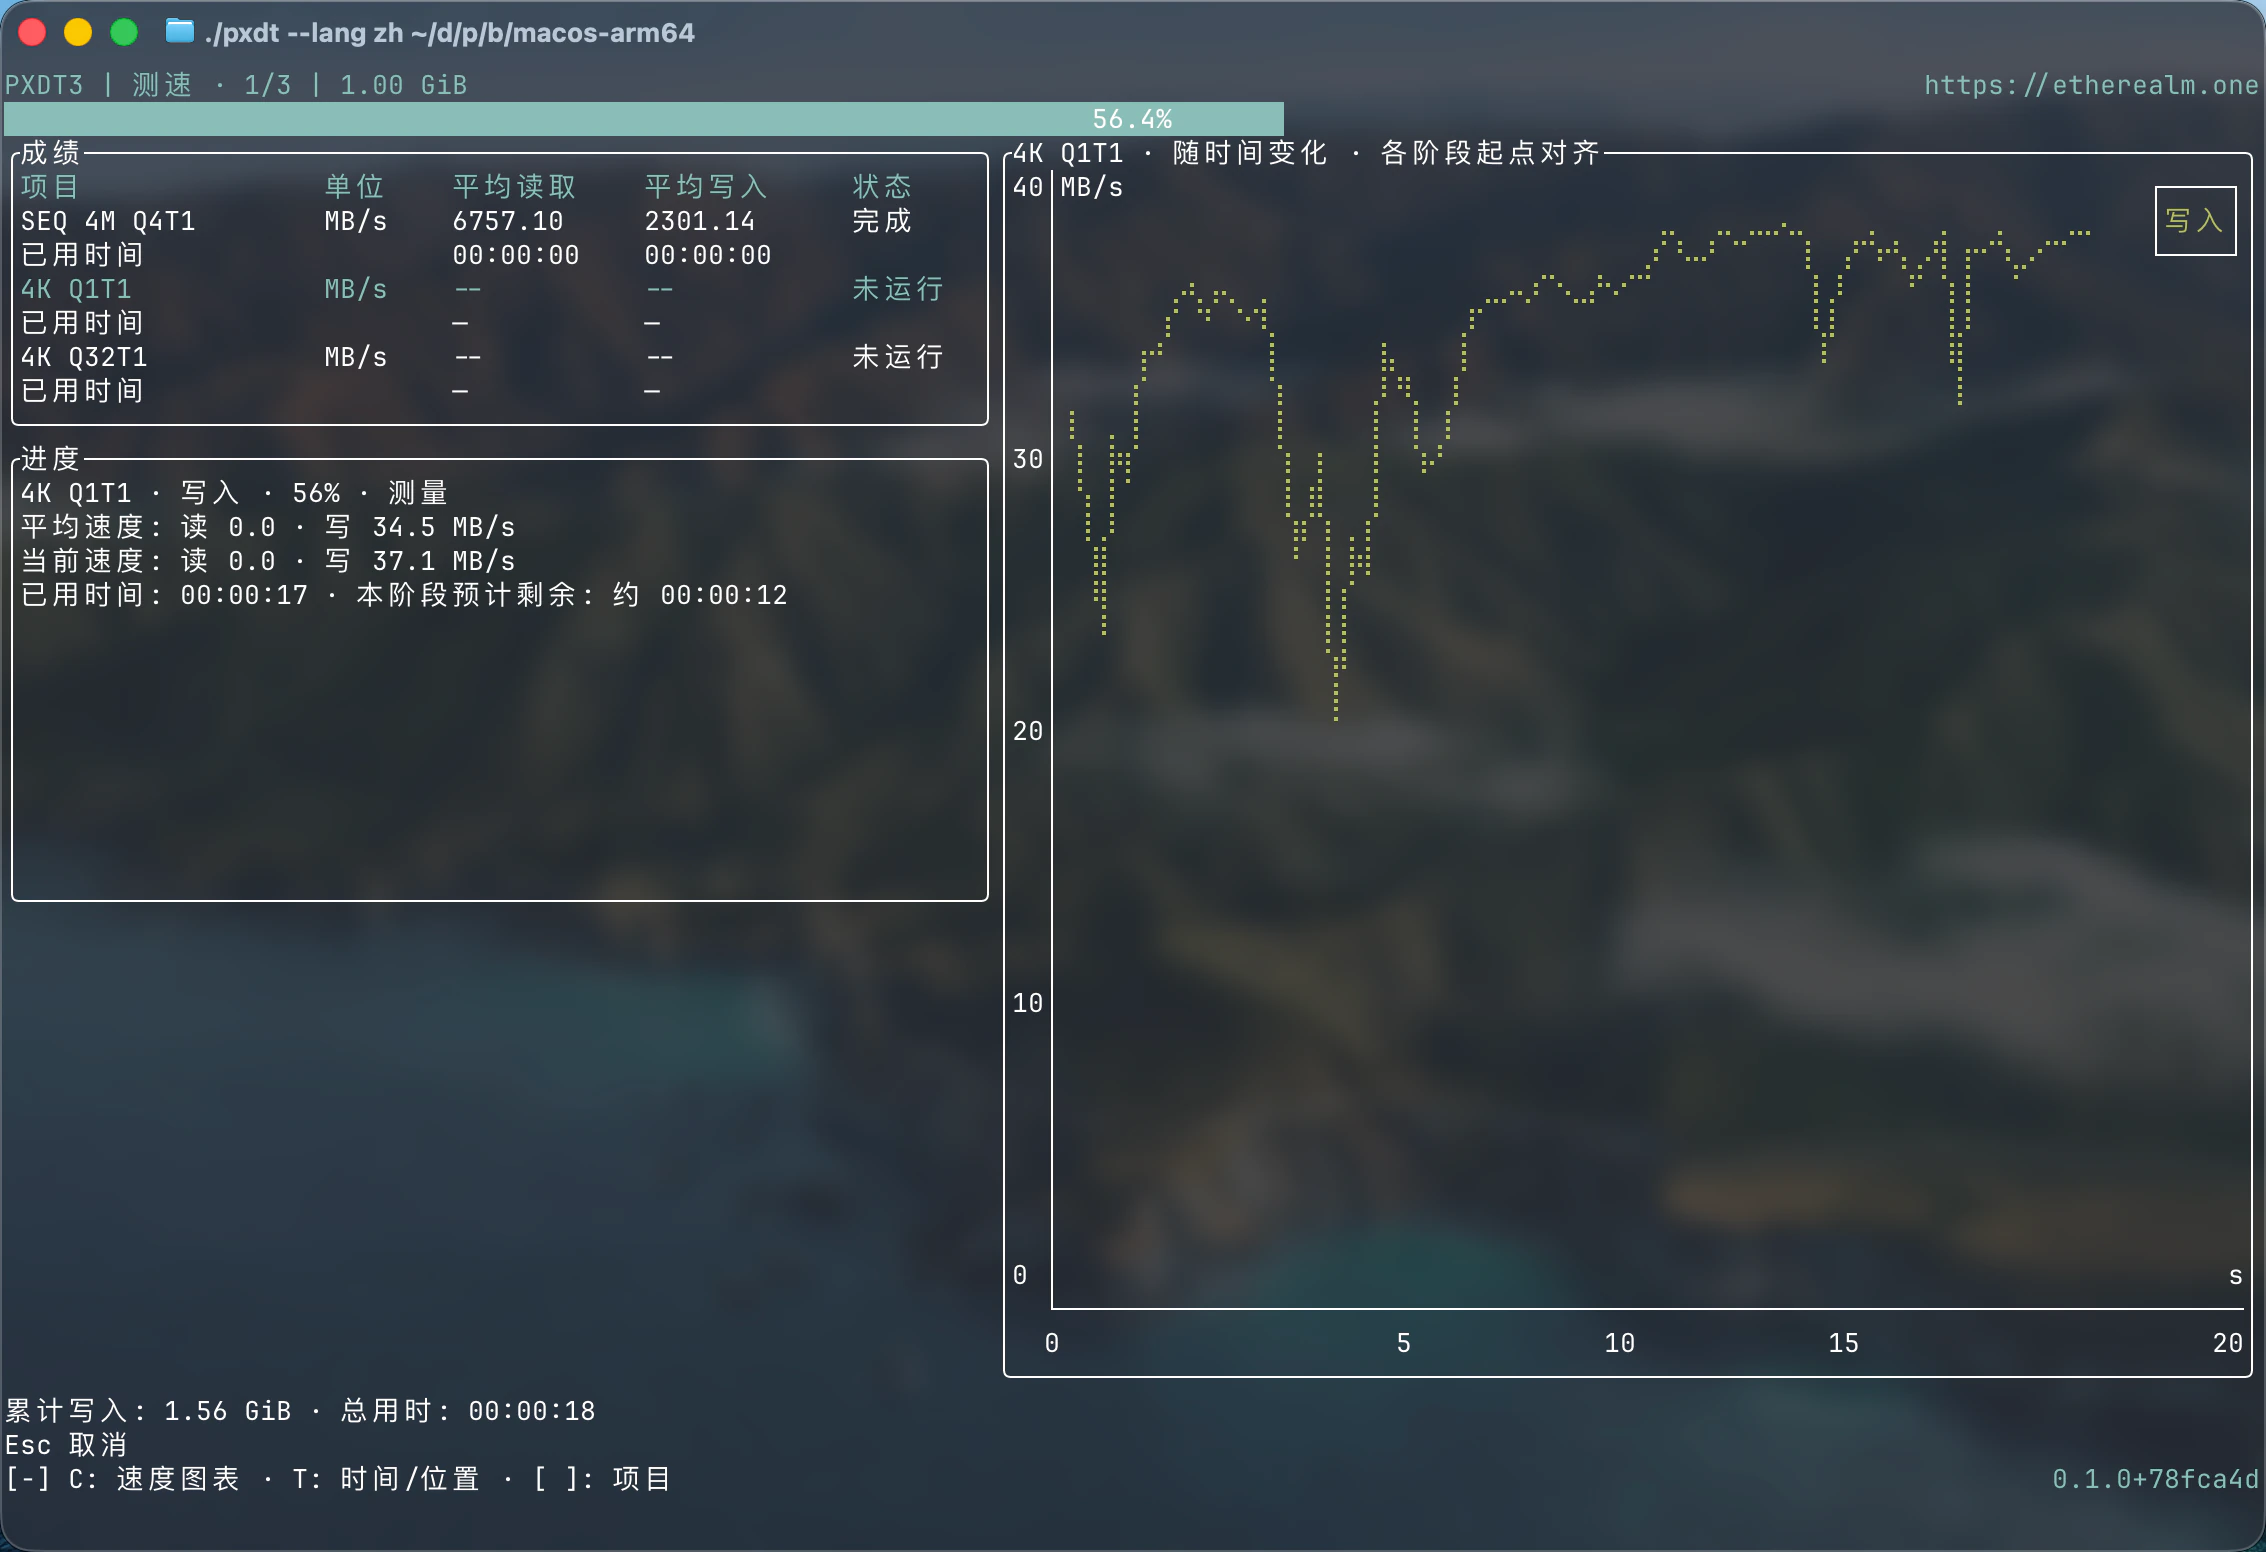
按 C 展开速度图表后,成绩和进度移到左侧,曲线占据右侧。时间视图把各阶段起点对齐,便于观察各自执行期间的变化。
写入校验:测试范围、校验结果与时间/位置视图
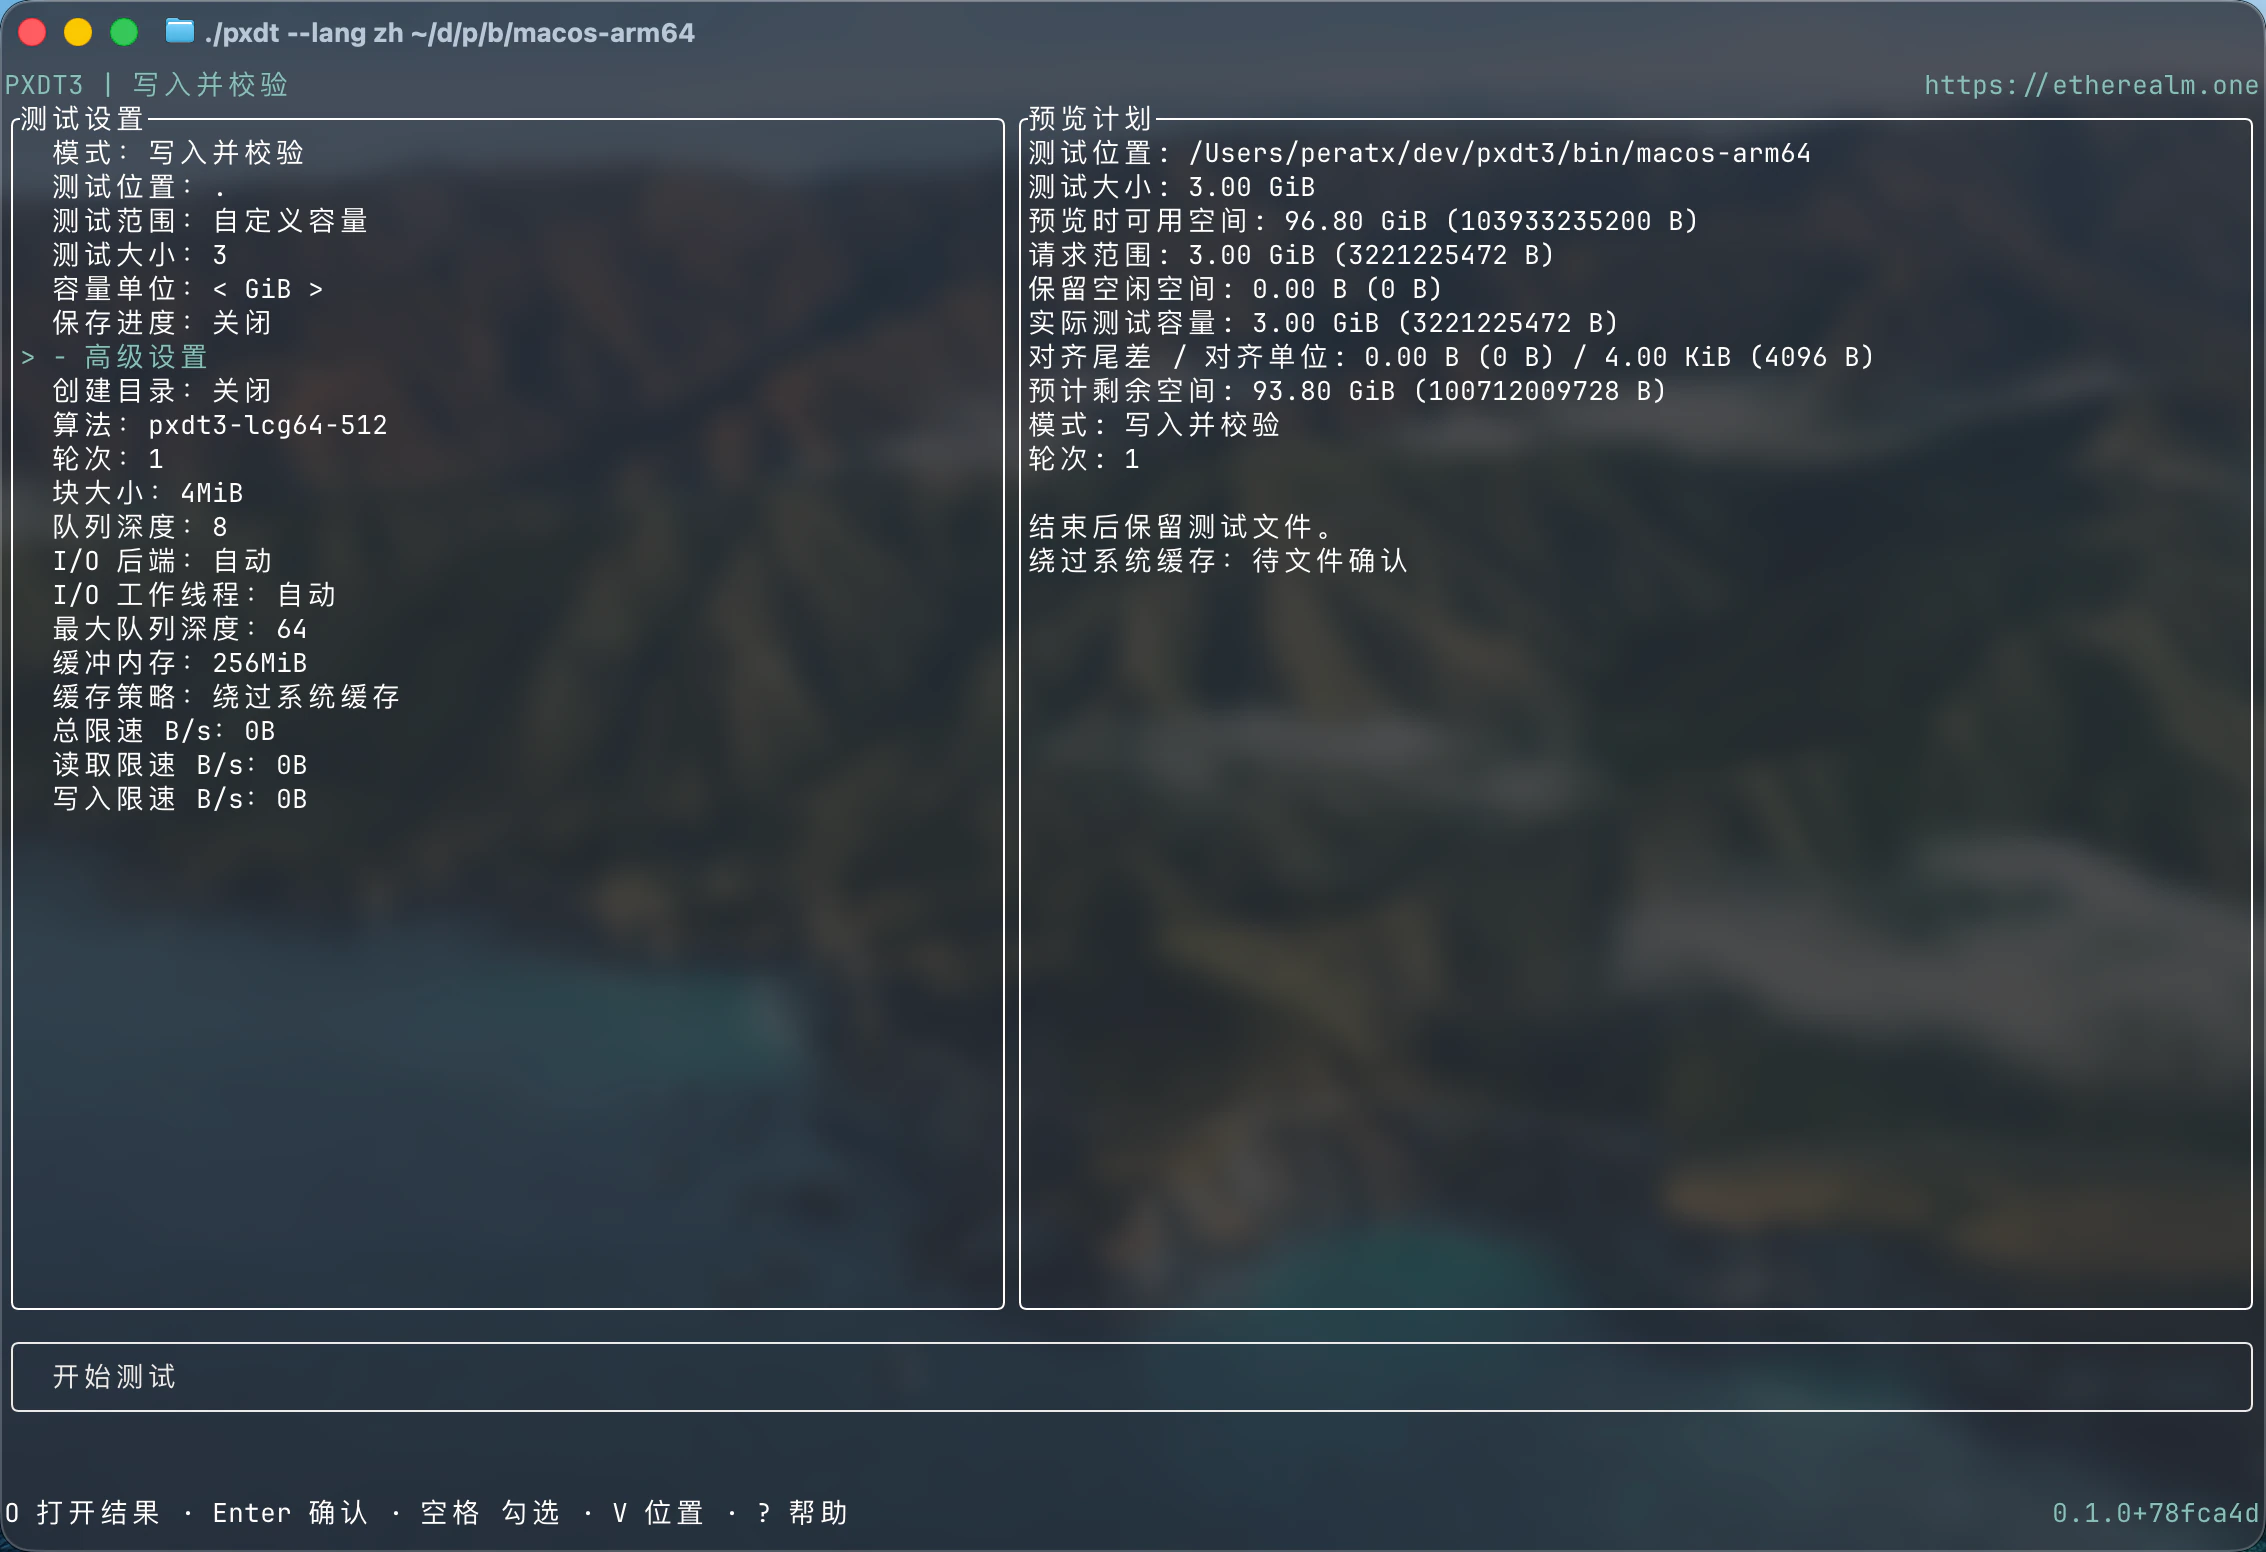
写入校验页沿用同一套设置与预览结构,参数围绕测试范围、算法、轮次和队列组织。
结果页把校验正确的范围、数据错误和 I/O 错误放在前面,再列出各阶段速度与耗时、累计写入量和文件保留状态。完成状态因此有具体结果支撑。
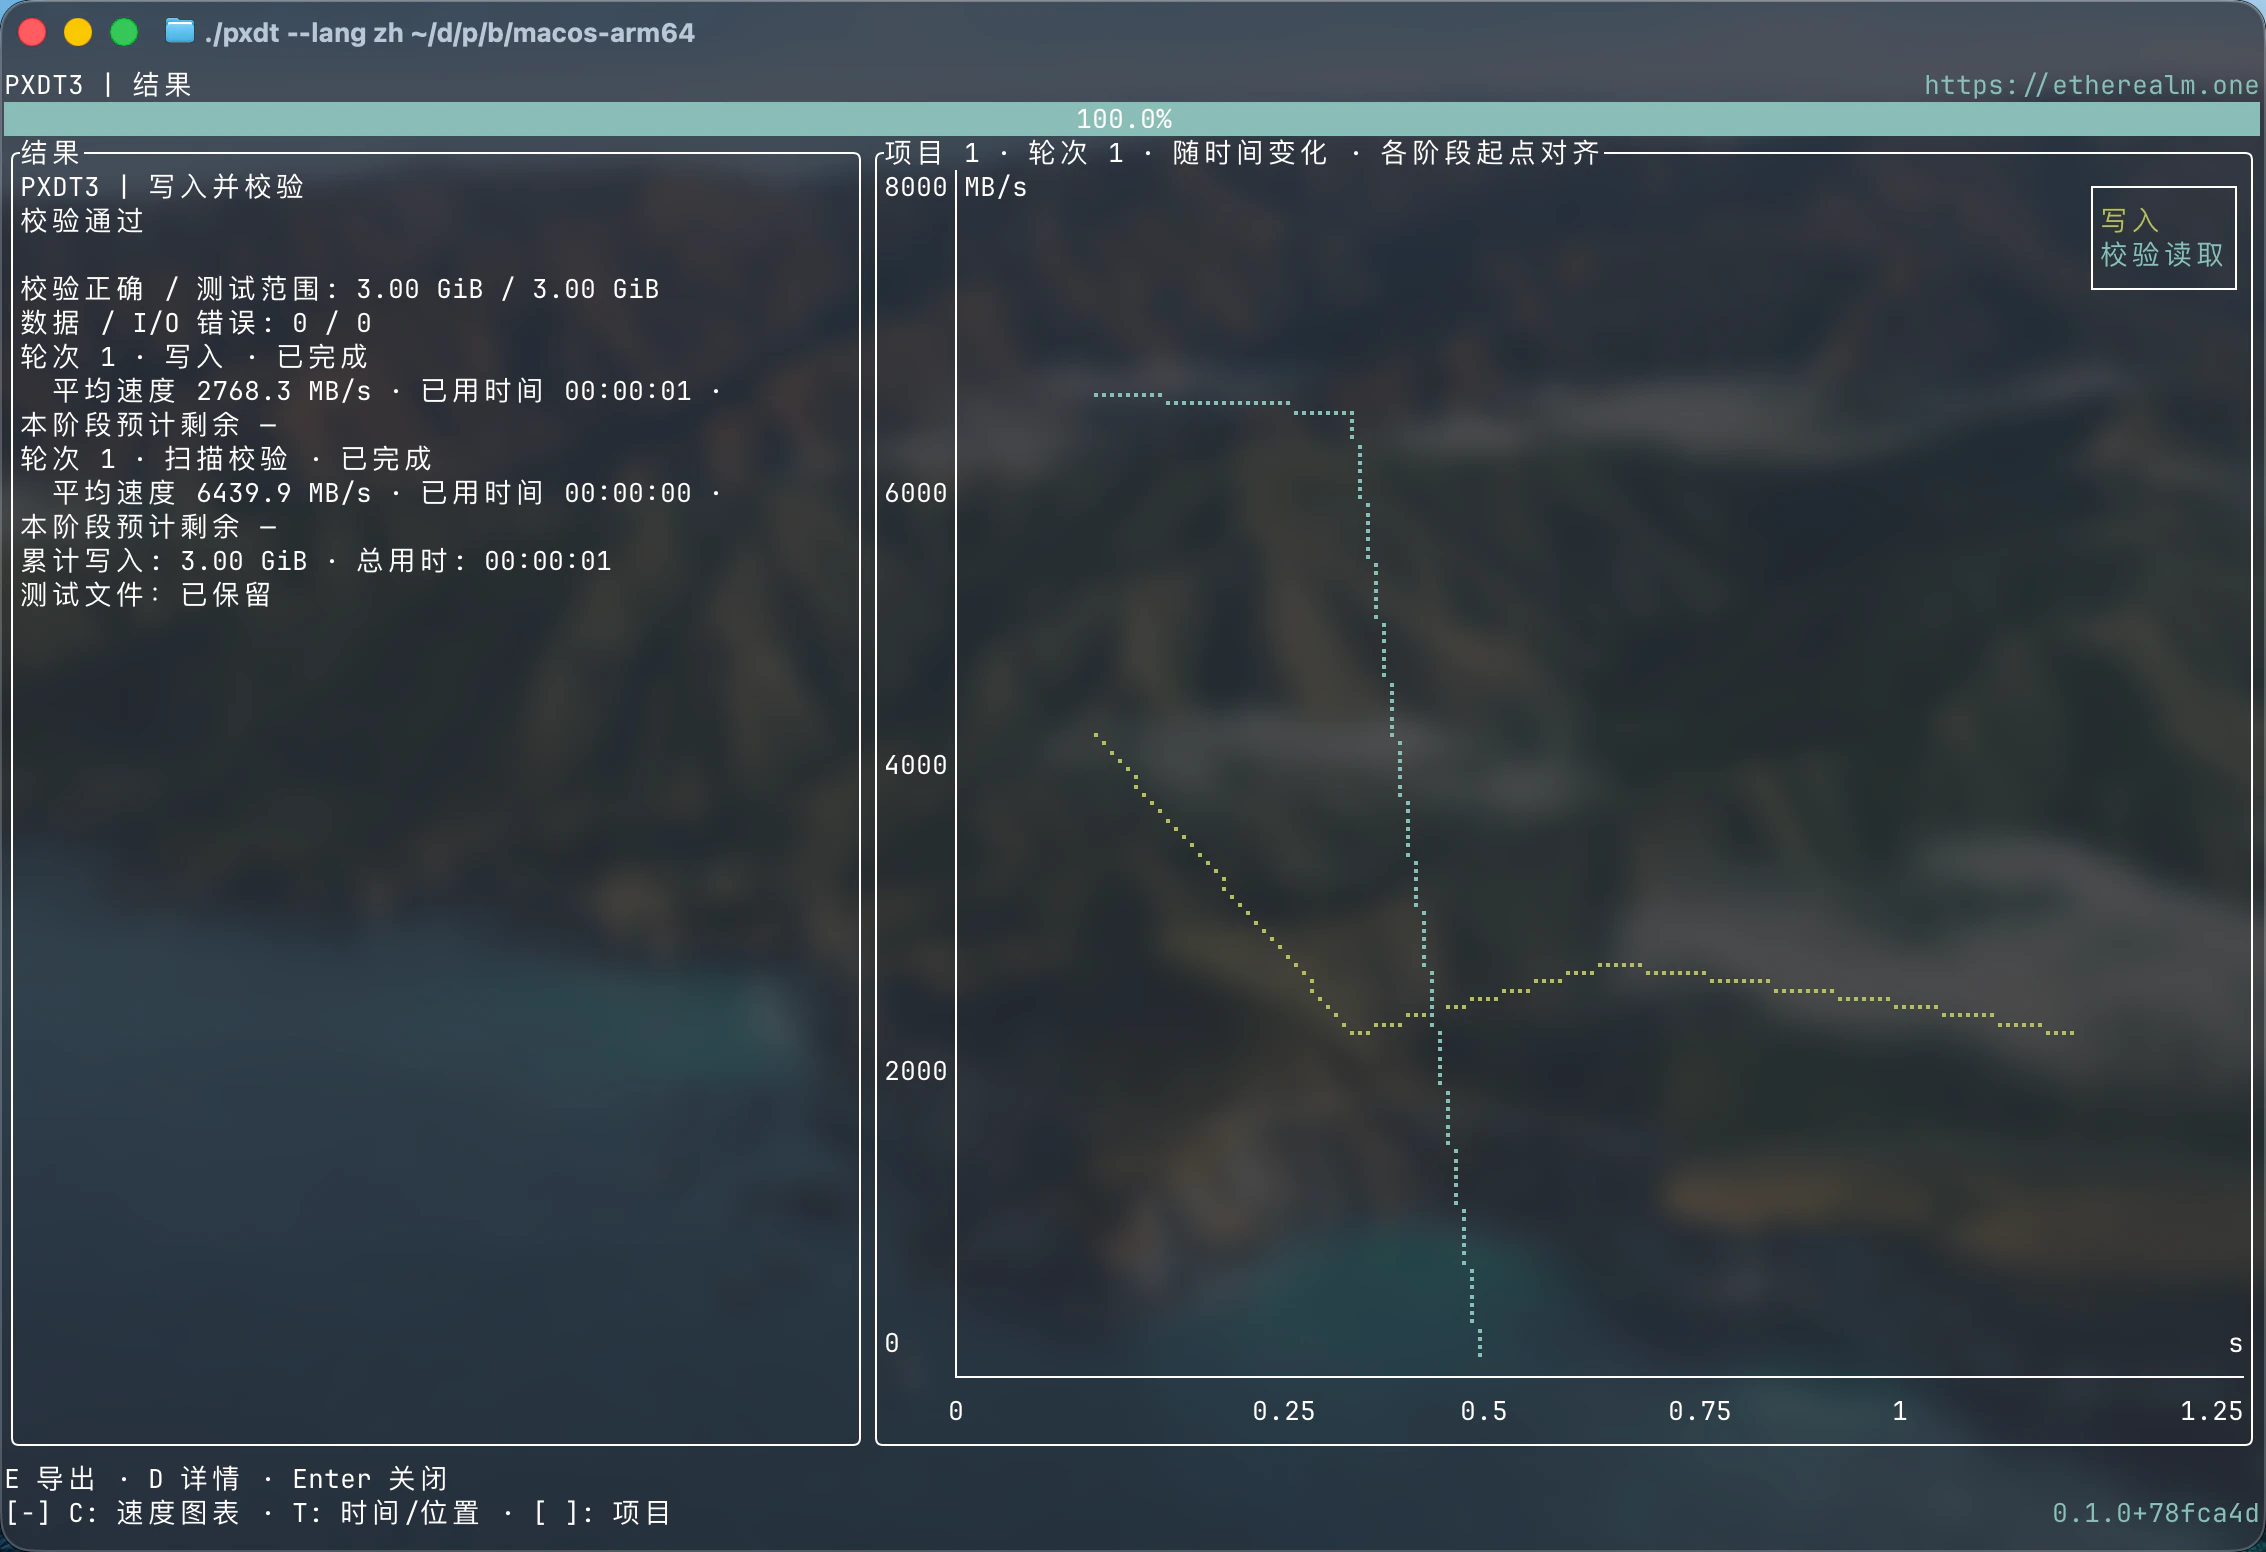
按 T 可以切换到测试位置视图。横轴从秒变为 GiB,用来观察不同测试位置对应的样本;它与时间视图采用不同的横轴和采样含义,读图时需要一起看清坐标与图例。
Workbench:把单次测试变成可复用的操作流程
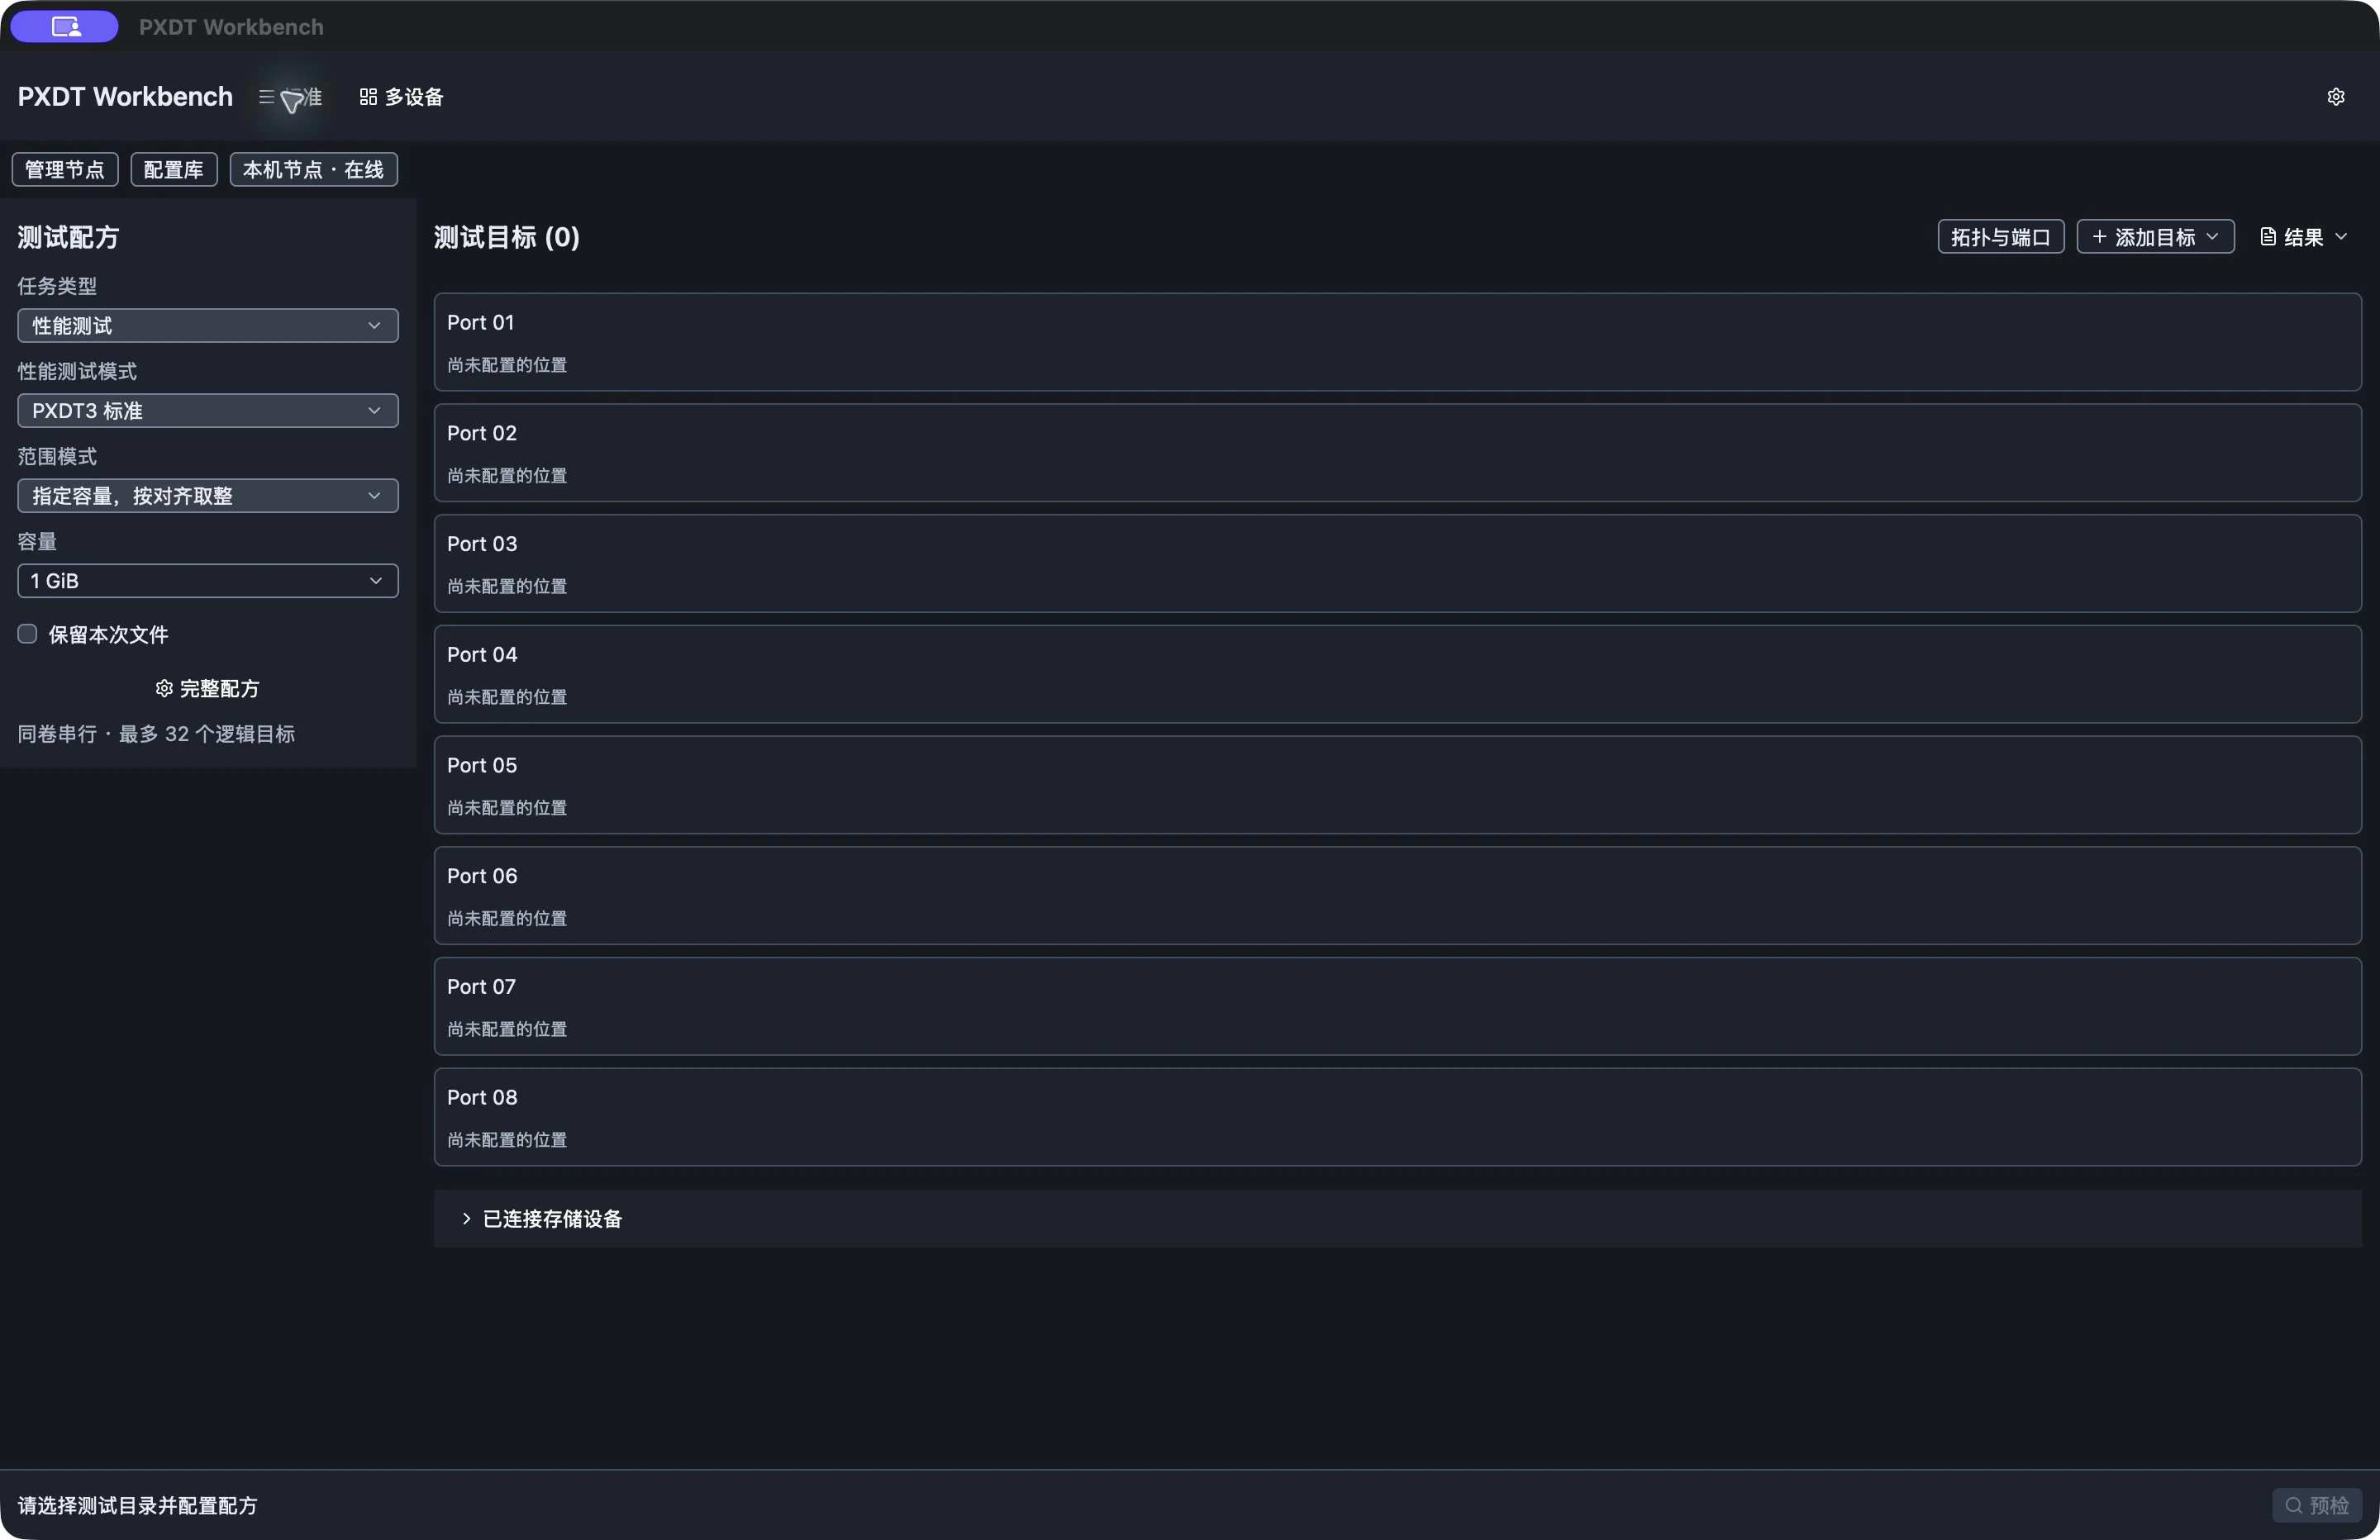
有了统一 Core 之后,我把桌面工作集中在三个环节:先把目标和参数说清楚,再显示实际能执行的计划,最后让结果可以重新打开。Workbench 已实现标准视图、多目标网格、完整配方和离线结果页,并接通 Windows/Linux 与 macOS 共用的桌面入口。常用任务与容量放在前面,Q/T、缓存、后端、限速和老化模式在配方中展开。
桌面采用 GPUI 与 GPUI-Kit。选择原生桌面路线,是为了把高频任务状态、设备列表和工位布局放进一个持续打开的工作台。界面层持有正在编辑的草稿;控制器负责把操作转换成后端请求;配方库、节点注册、结果模型、图表模型和工位模型各自独立。真正开始执行后,计划和任务状态归后端所有,界面重新渲染或切换页面时不用重新组织测试。
下面保留 10 月 16 日 macOS 应用的真实界面。截图时本机 Node 在线,尚未添加测试目标;Port 01~08 是尚未配置的位置。这个空状态保留了工位布局,也让下一步选择目标的入口保持可见。
配方、目标、预检和开始各自负责什么
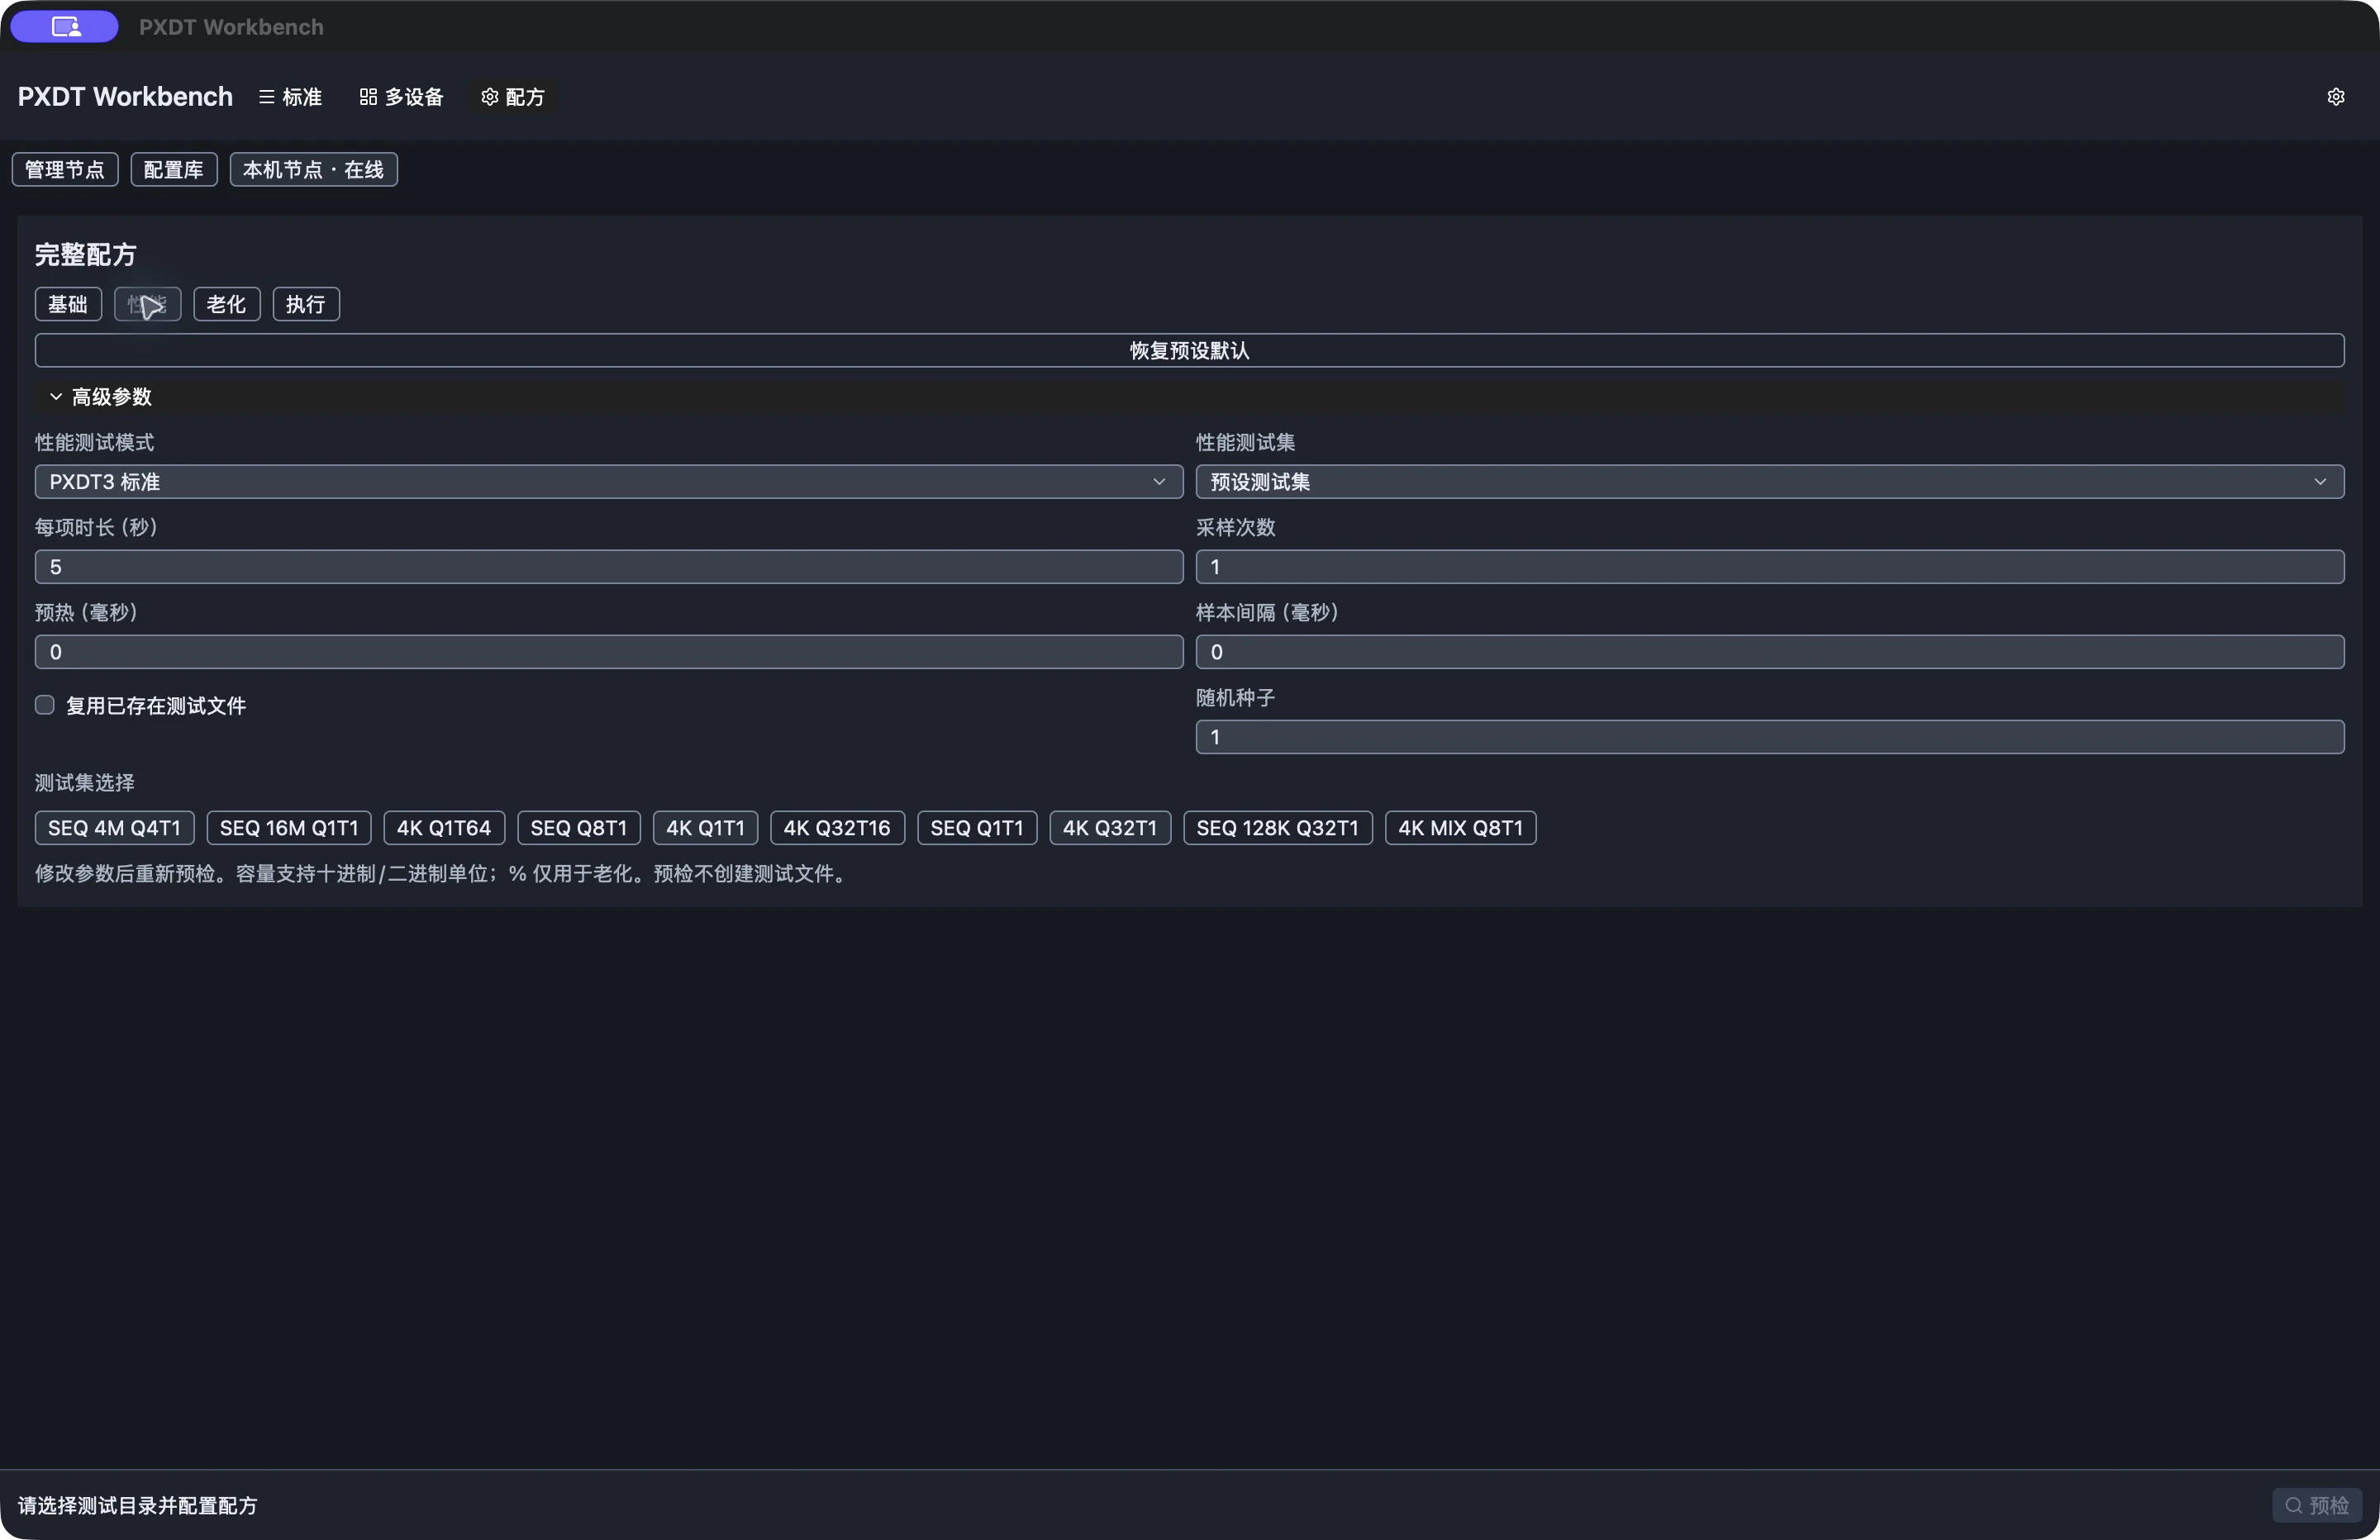
标准视图服务日常操作,多设备视图把更多空间留给工位卡片,完整配方页承载低频参数。这三种入口共用一份任务草稿:从标准页选择性能模式,再进入配方页调整采样时长与测试集,返回后看到的仍是同一任务。写入校验、性能测试与老化继续使用 Core 的工况定义,TUI 与 Workbench 的差别主要在操作组织和信息密度。
10 月 17 日统一了面向操作者的容量输入:十进制容量至少 10 MB,二进制容量至少 10 MiB,CLI、TUI 和 GUI 使用相同规则。4 KiB 等 I/O 块大小继续用于负载设置;程序化 JSON/SDK 仍使用精确字节合同。切换任务类型时,隐藏的测速线程、负载和计时输入也只在对应模式生效,避免上一种任务的编辑状态干扰当前计划。
预检会固定实际范围,检查目标、空间、对齐和内存,再显示首轮能够准入多少个任务、其他任务为何等待。修改参数或目标后必须重新预检。一个 Node 当前接受一个活动批次,最多包含 32 个逻辑目录;worker 配额为 1~4,实际并发继续受节点、控制器预算与卷租约约束。同一逻辑卷上的任务串行执行,界面中的目标数量因此需要结合实际设备关系理解。
管理中心将节点连接、测试配方、目标集合和工作区放在一起。配方有不可变修订,目标集合可以绑定一个确定的修订;以后编辑配方,已有集合仍指向原版本。工作区保存各节点的草稿、选择和布局,恢复后重新预检,由操作者明确开始任务。这样,重复测试可以复用设置,同时保留每次执行前的目标核对。
例如,一条产线保存了“顺序写入+读取校验”的配方修订,又为某个 Node 保存了一组测试目录。下一班恢复工作区后,可以继续使用这组配置;如果上一班修改了配方,旧目标集合仍能明确指出它使用的版本。如果设备被换走,或者目录背后的卷改变了,本轮预检与目标守卫会重新处理现场事实。配置复用与执行许可由此分开。
| 对象 | 保存的内容 | 变化后的处理 |
|---|---|---|
| 节点连接 | 地址、显示名称与连接配置 | 重新连接并读取该节点当前状态 |
| 配方修订 | 一组确定的算法、负载与执行参数 | 修改产生新修订,旧修订继续可追溯 |
| 目标集合 | 节点、目标与绑定的配方修订 | 加载到草稿后检查当前目录与设备 |
| 工作区 | 节点草稿、选择与布局 | 恢复编辑现场,重新预检并明确开始 |
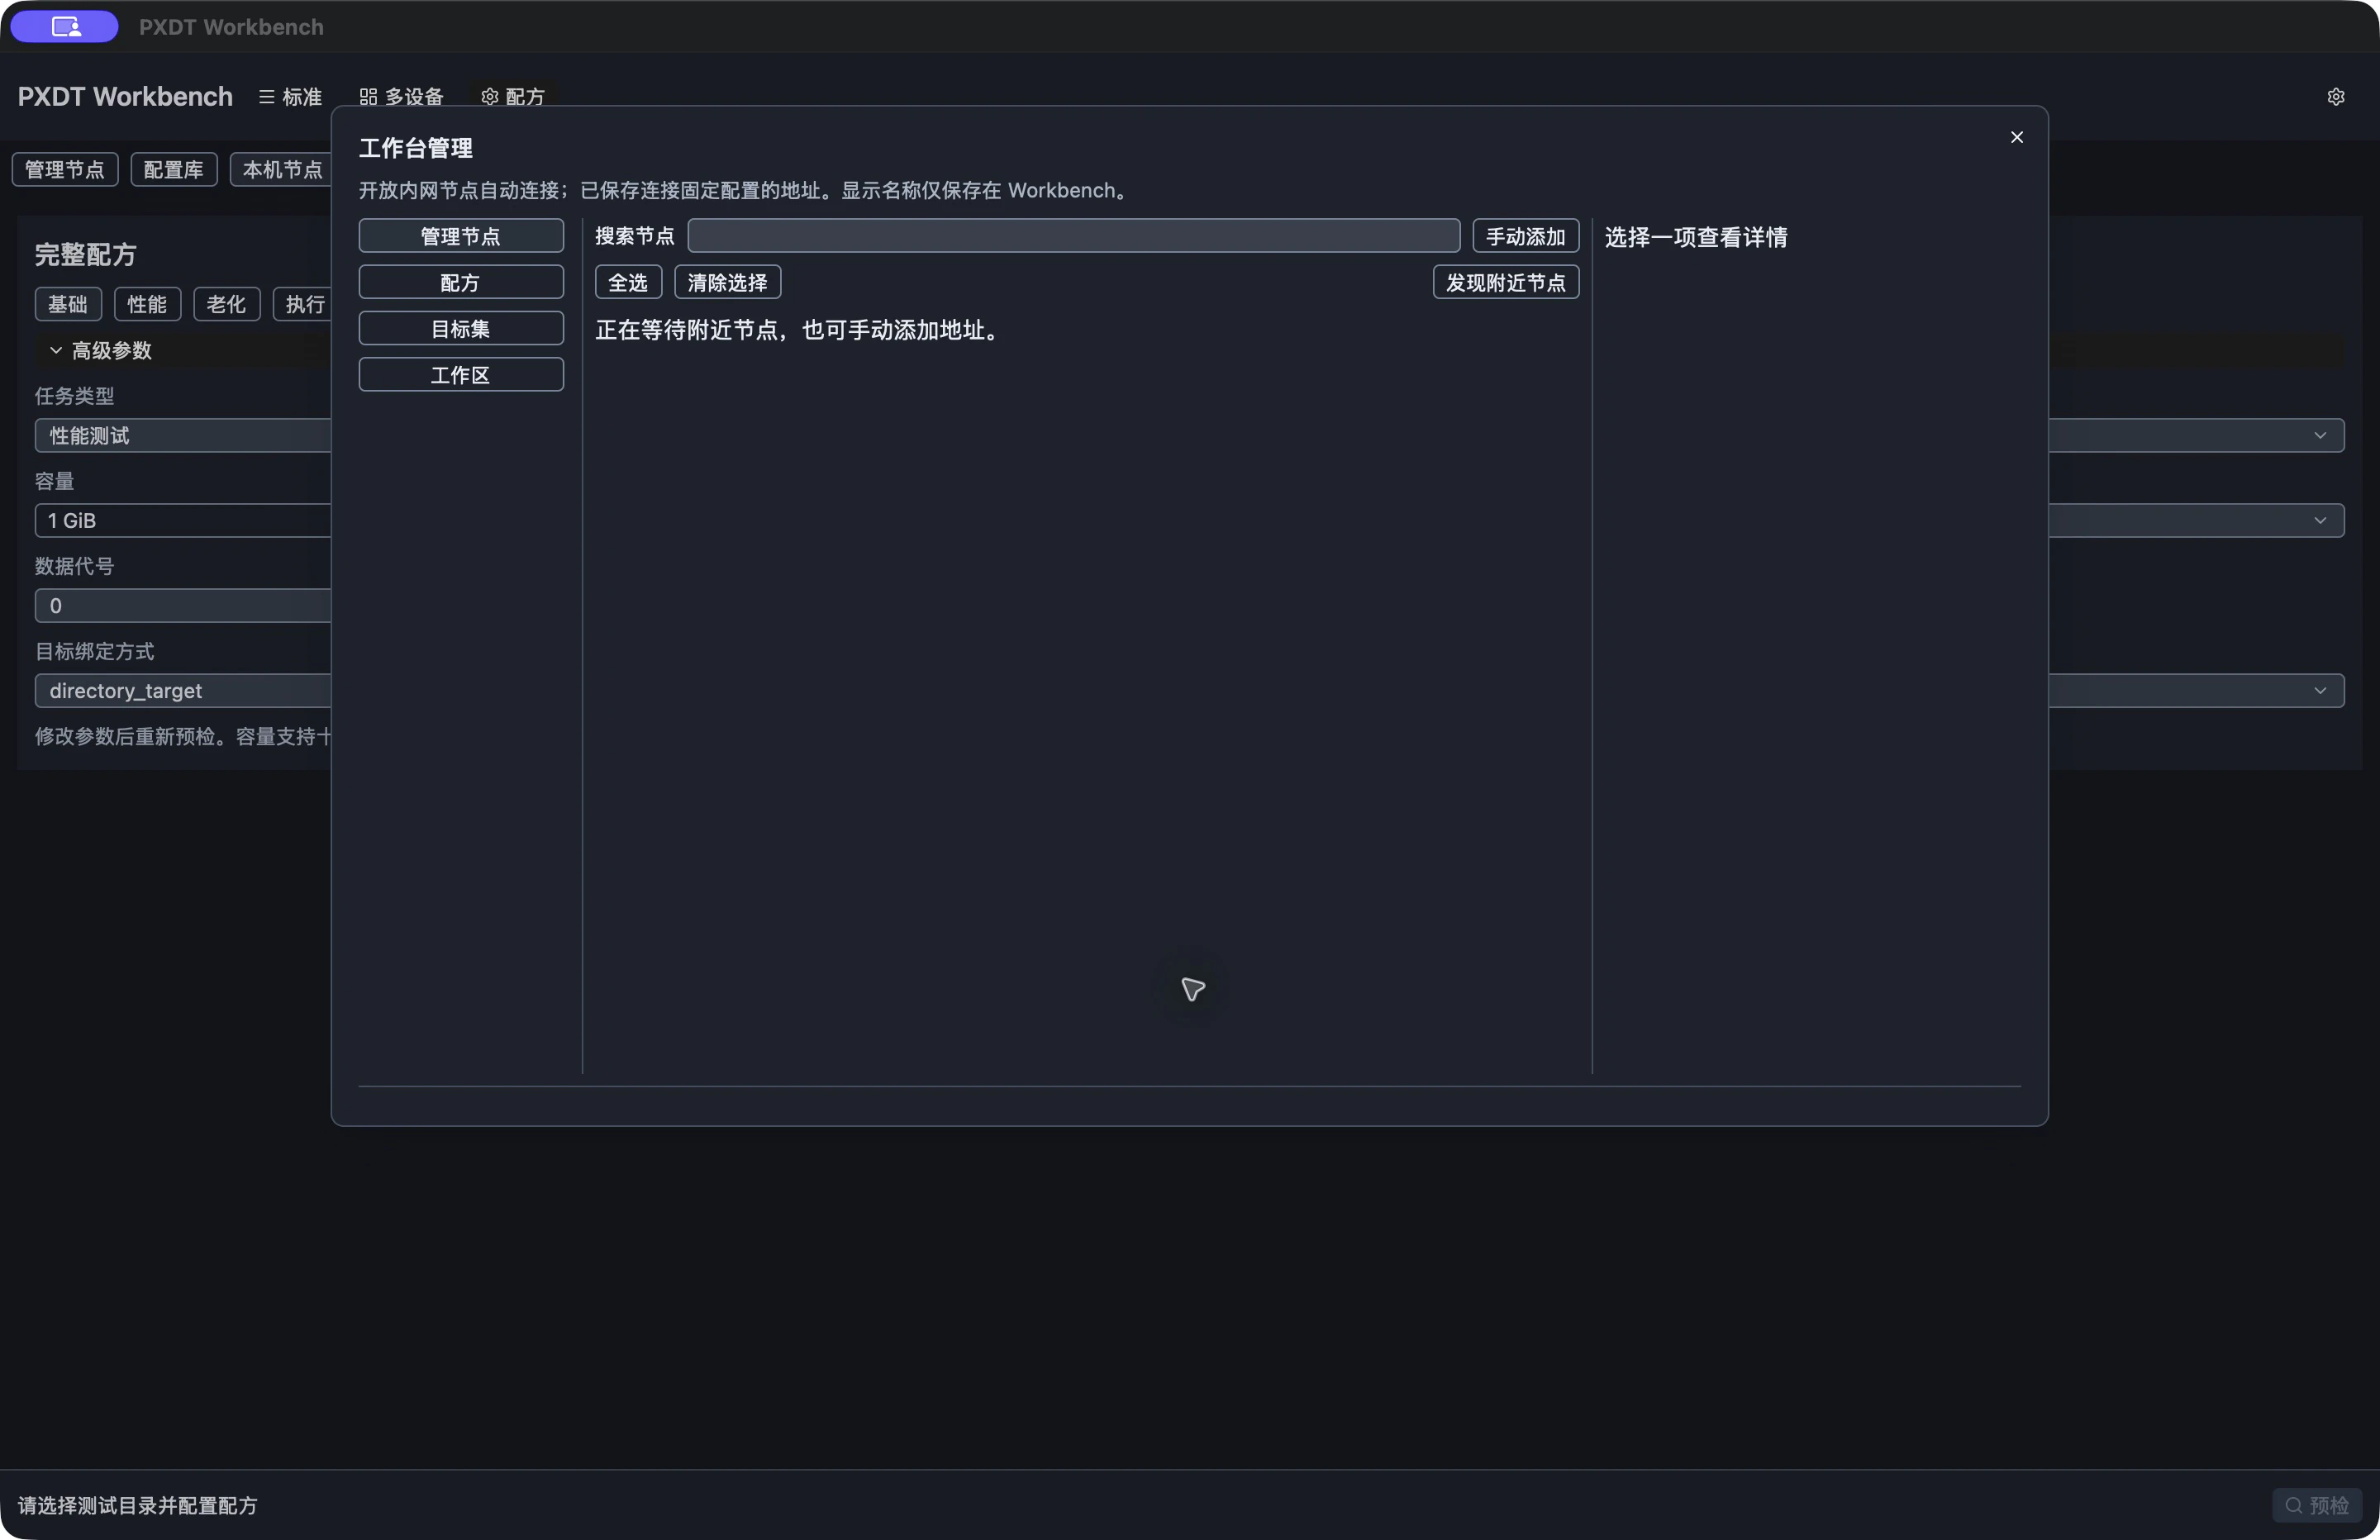
管理中心截图展示的是等待附近节点的状态,本机 Node 的在线状态仍显示在工作台。自动发现、连接和刷新主要消除地址输入与状态查询的重复劳动;启动测试始终经过目标选择、预检和明确提交。
多设备视图保留现场位置
多设备界面把每个位置持续留在网格中。设备离线后,位置和旧任务仍有地方可看;换入新设备后,也能区分上一轮结果与当前占用。卡片的执行状态与测试判定分别展示:等待、运行、排空和结束描述任务生命周期,通过、失败或缺少判定依据描述测试结果。
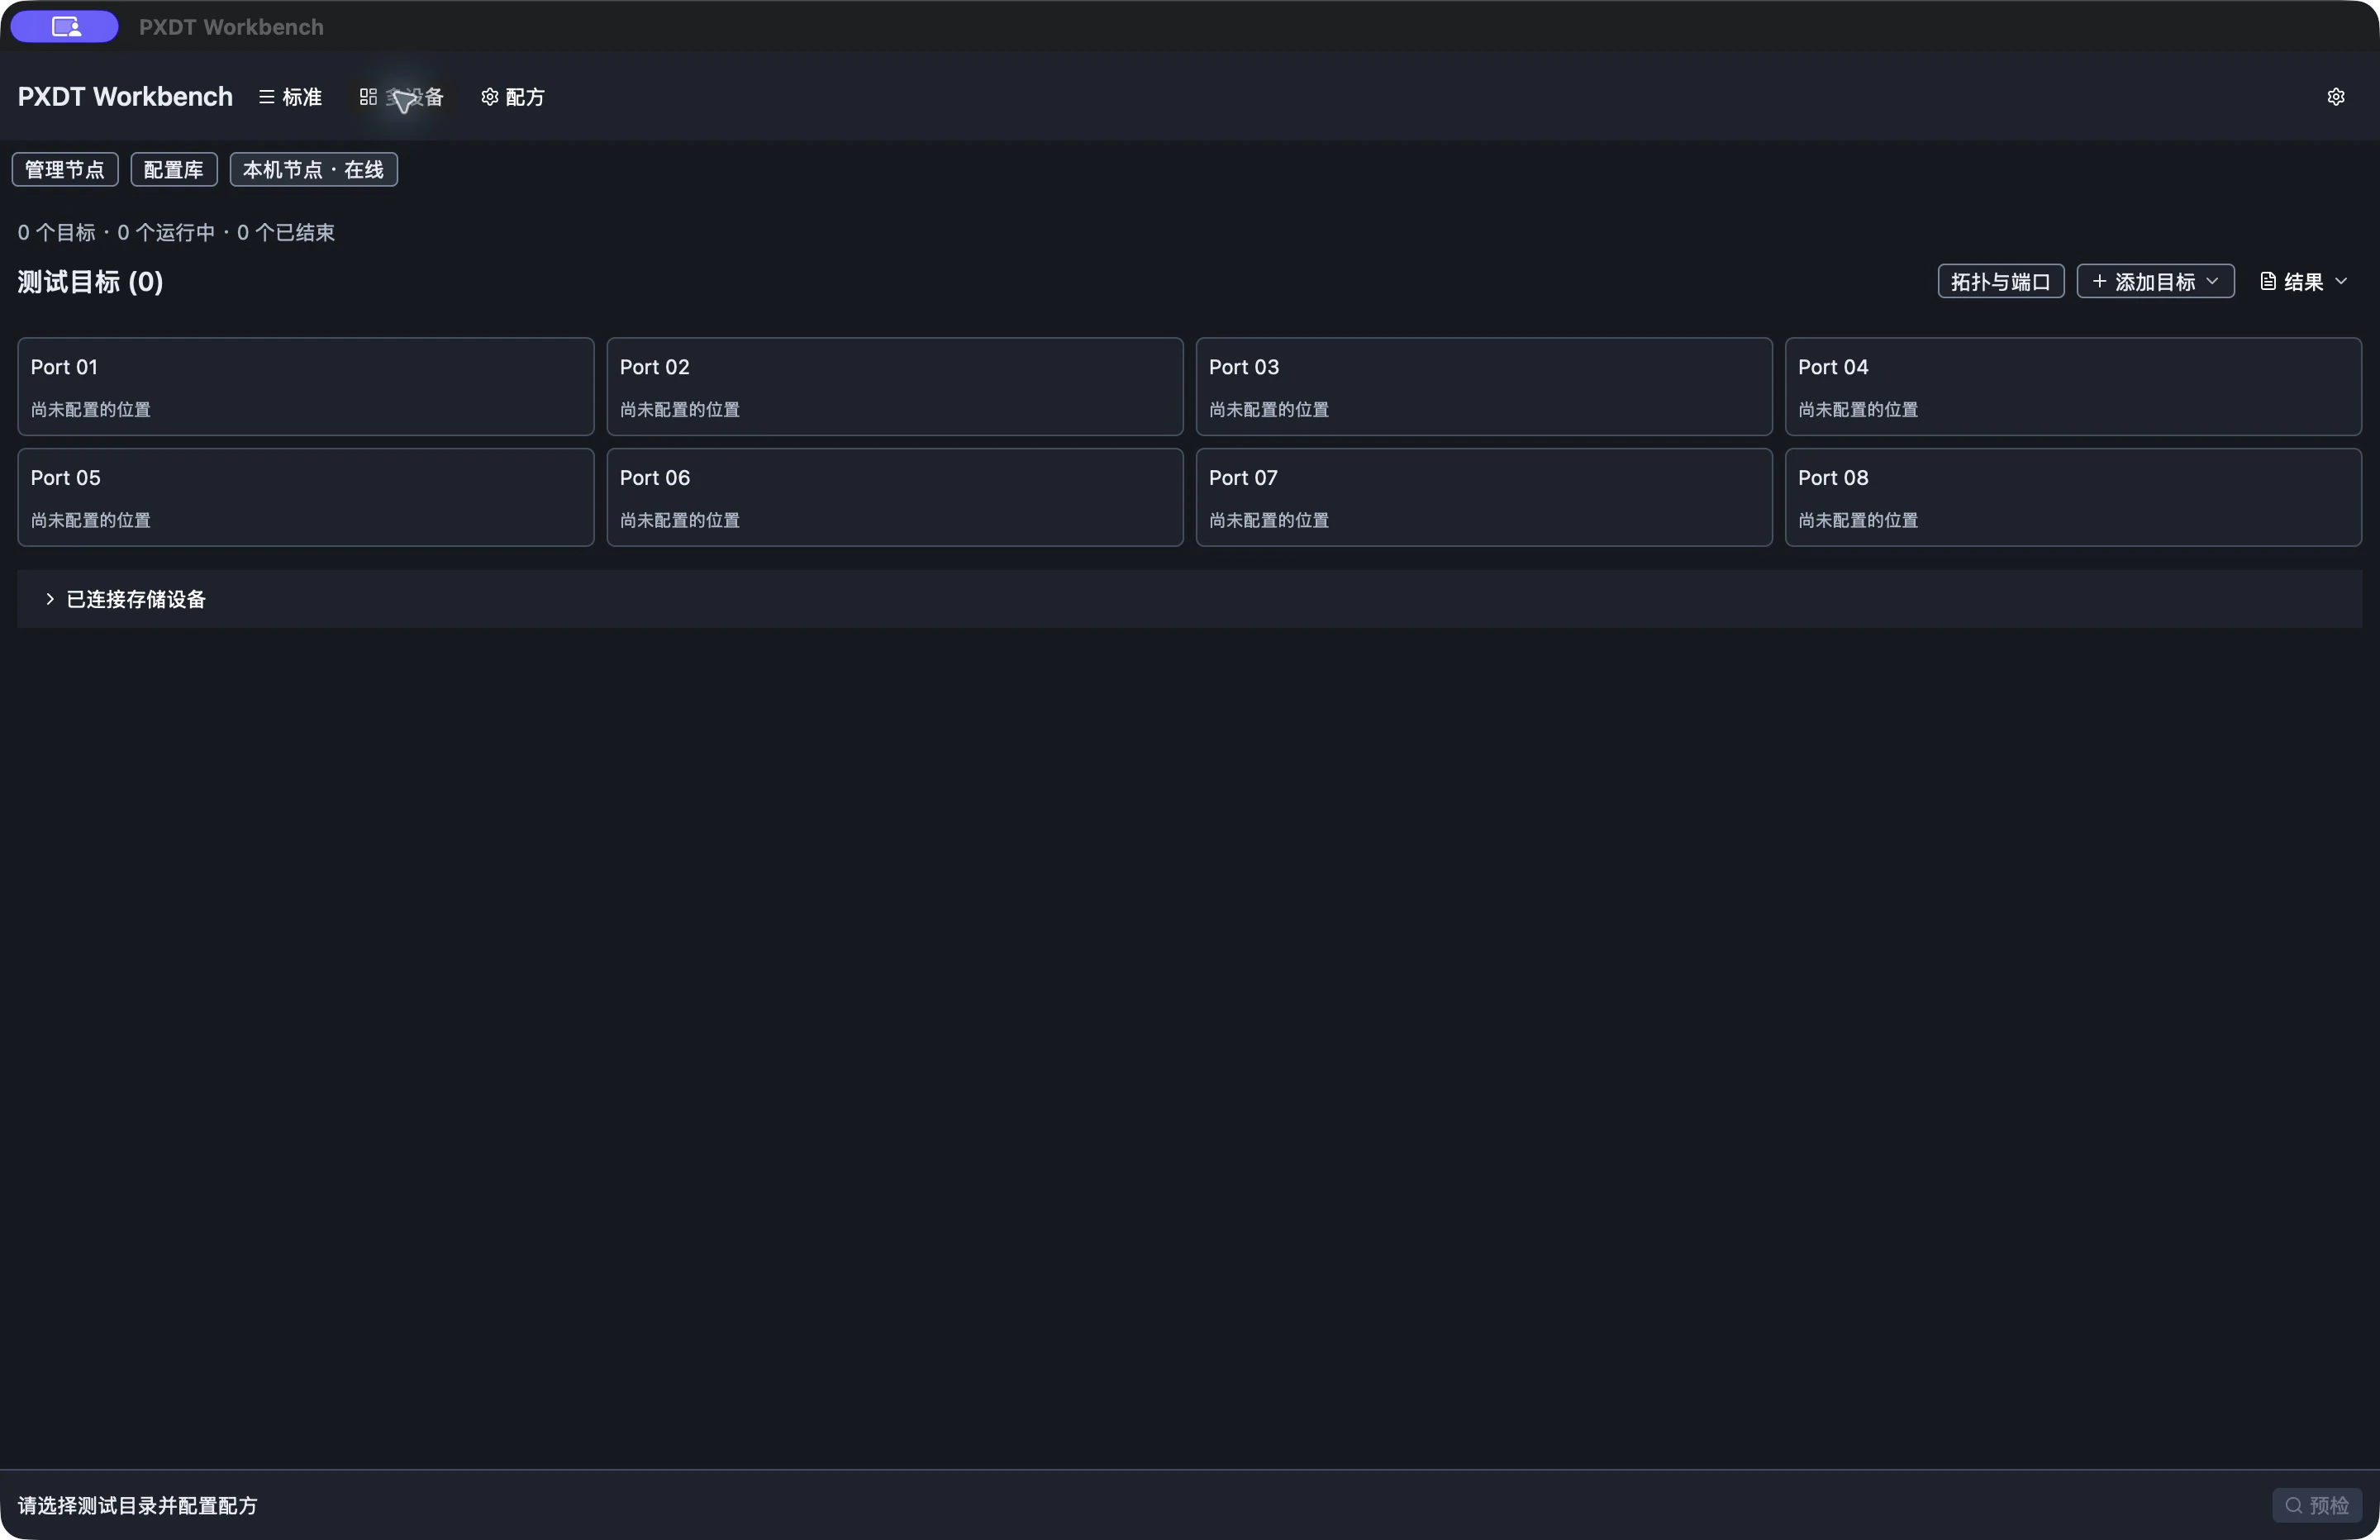
当前界面可组织最多 32 个逻辑目标。工厂真正关心的还包括控制器共享、设备掉线、旧结果留存和下一轮如何接续,这些约束由下面的 Orchestrator 与设备层落实。GUI 后续还需要完善批次历史检索、归档保留策略和更大规模的操作体验;Windows/Linux 桌面的共享代码已接入,各图形环境与操作流程继续分别验收。
图表与结果:从时间变化看到测试位置
结果页以结论和有效成绩为先,读写速度、IOPS、延迟与具体工况一起展示;未测量、取消或失败的方向保留状态。测速完成表达该工况的测量已结束,写入校验则报告实际成功比较的范围。Core 原始结果与可用健康窗口可以导出、离线打开;历史批次还会保留当时的计划和编排状态。
时间曲线观察负载执行期间的变化。Write/Verify 的位置散点继续使用 Core 采集的逻辑区域记录:横轴表示测试范围内的位置,纵轴表示该区域的吞吐,缺少区域记录时保留空缺。这里的位置属于测试文件的逻辑范围,SSD 内部的闪存映射由设备固件管理。
10 月 17 日,我重新处理了 Bench 散点图呈直线的问题。此前把某区域从首次提交到末次完成的时间包络用于计算区域均速,随机请求又会反复访问同一区域,最终容易把整段变化压成相近的平均值。调整后的“完成量散点”以本轮测量累计成功完成的读+写字节为横轴,以真实测量窗口中的吞吐为纵轴。随机访问地址不参与这个横坐标,重复流量也可以超过工作集大小。
10 月 18 日的后续优化把默认展示统一为时间折线,完成量散点保留为可切换视图。两种图分别保存连续趋势与真实窗口:时间图适合观察速度变化,散点适合检查随着累计工作量推进出现的高低点。CLI/TUI 与 Workbench 使用同一套投影,窗口变窄时合并相邻区间,已有成绩和保存的历史保持原值。
例如,计划传输 1 GiB,取消时成功完成了 500 MiB,散点只画到 500 MiB,后半段留空。这个图回答“完成到这里时,速度怎样变化”;文件写入校验的位置图则回答“测试范围的哪个区域慢”。两者使用不同采集合同,界面按任务类型明确标注。
Bench 的完成窗口、多线程与长历史怎样保持真实变化
Core 默认按共同起点的 100 ms 窗口统计,高级设置可选 10、20、50、100、250 ms。采样档位只改变图表采集细度,测试量、测量时长、界面刷新和健康采样各有自己的设置。各提交线程批量汇报成功完成字节与请求数;窗口速度以所有线程在该窗口的完成量除以一次墙钟时间。Q/T 描述并发配置,速度直接来自完成量。预热、文件准备、失败请求的部分返回和定时终点后的排空分别记录,不进入该轮成功测量窗口。
散点与时间图使用同一组真实窗口。独立读写各自从零开始,同 profile、同轮次配对;混合负载共用累计读+写量轴,保留读、写和合计速度。停顿窗口保留零速,完成量轴停在原处;缺少样本的时间不连线、不插值。
连续趋势拥有独立的有界历史,合并相邻区间时保留完整字节数与时长;散点历史另行保留真实首末和速度极值窗口。时间图因此可以在散点压缩后继续呈现连续趋势。显示均速使用合并字节数除以合并时长,在区间中点连接普通折线;真实缺口断开,单窗口显示一个点,同一连续段的短尾向前合并,减少短尾造成的波动放大。
每个保留阶段最多保存 128 个 Bench 趋势区间,任务最多保留 64 个阶段;散点汇总与 Write/Verify 时间记录另有共享预算。窗口的原始时间与完成量保留,界面按当前视图显示压缩状态。测速套件还共用一份文件清单,各工况分别记录自己的文件完成状态,减少重复内容对结果文件和远程消息大小的影响。
结果、取消和操作入口一起收紧
图表需要忠实反映完成量,离线结果也需要校验自身是否一致。10 月 18 日的修复进一步检查成功结论、任务模式和覆盖量:范围通过必须来自写入校验或独立校验,并覆盖非零的选定范围;只写完成保留“尚未校验”的含义;测速完成对应测速模式。独立 verify_only 固定执行一轮,Rust、JSON、C ABI 与界面保持一致。
批次取消处理了另一个容易被忽略的时序:操作者按停止时,worker 可能刚好自然完成。现在取消受理与可靠终态发布共享短事务锁;终态后的遗留命令得到 already_terminal 回执并清理,自然完成保留原结论。恢复流程也会处理这类残留命令,存储失败则继续返回错误。
操作入口随之调整。Workbench 的固定底栏保留“停止所选”,标明目标编号,滚动目标列表时仍可操作;导航高亮与实际显示内容保持一致。TUI 返回参数页时保留字段焦点,测速模式使用本地化名称。公共标题区域还会按实际进程身份显示 root 或管理员标记,具体设备能否访问仍由查询结果表达。
这些调整把“操作者发出了什么请求”“任务实际到哪一步”“最后保存了什么结论”连接起来。正文中的界面图片仍来自 10 月 14 日与 16 日,新增入口与标记以上述当前实现为准。
Device:让设备事实拥有独立的来源与解释
早期工具主要围绕测试文件工作。到了多设备工厂环境,目录后面是什么卷、卷落在哪个设备、健康计数属于哪个控制器,都需要持续回答。我把这些能力收进独立的 pxdt-device,让 CLI、Workbench 和 Node 共用。Core 可以专注于生成数据、提交 I/O 和比较结果,设备观测也可以离线回放、独立演进。
Device 内部把发现设备、采集健康信息、识别型号和解释指标分成四种职责。发现层描述系统当前可见的设备与路径;采集层保留工具或原生接口返回;识别层判断设备身份与适用规则;解码层按有依据的单位解释数据。当前已接入 smartctl、Linux/Android 原生 eMMC 与 UFS 读取,并提供离线回放。原生系统后端可分别关闭,协议证据与解码仍可独立使用。
一次测试前后的健康窗口
设备观测先关联目录、卷和设备,再采集健康数据,保留原始输出、解释结果、时间、来源和不可用原因。高精度测速采用前后采样时,运行窗口中的额外采集干扰较少。完整窗口从基线采样开始,经过 Core 执行与 I/O 排空,最后完成终采;外部工具和原生阻塞查询都在受监督的辅助进程里执行。周期采样目前仅对受支持的 macOS 内置 NVMe 路径开放,Windows 与 Linux/Android 保留各自的单次或前后采样范围。
Host 读写计数描述设备报告的流量,可能包含其他程序的访问;测试自身完成了多少字节由 Core 记录。多个 namespace 或目录共享同一个计数域时,设备增量只记录一次。NVMe Host Data Units、ATA 原始属性与 NAND 写入量分别按有证据的单位解释,单位未知时保留原计数。
可选 SMART 采样失败时,界面显示缺失原因,普通文件测试仍可执行。权限不足以 requires_elevation 返回,由操作者决定后续处理;采集器不会自动提权。若失败的是任务依赖的目标身份关联,则撤销绑定并停止后续提交,进入排空与归档。
结构化诊断在归档中保存消息标识和参数,由共享 rust-i18n 按界面语言渲染。切换中英文时,已有诊断可以重新显示;操作系统或外部工具的原始错误继续保留原文,便于追查来源。
SMART 详情从摘要扩展到完整结构化字段
只显示温度、通电时间和总写入量,很容易遗漏定位问题所需的属性。现在 TUI 的设备详情页直接消费共享层的结构化 section、field 和 table:ATA 展示完整属性表,包括 ID、标志、当前值、最差值、阈值、失败记录与 RAW;NVMe 和 SCSI 则按实际返回内容展示字段、日志和错误。
标准字段、状态与单位提供中英文标签,厂商属性名和未知字段保留原文。大整数保持精确十进制字符串,序列号等文本保留前导零;同值的不同编码副本合并,冲突副本分别显示。未知单位保持未知,部分采集成功时留下已获取字段及其余错误。
终端通过纵向与横向滚动查看完整表格,按 R 重新采样。采集、解码和语义识别集中在 Device,TUI 负责本地化与布局;JSON 和 C ABI 可以取得同一份详情,其他界面也有共同的事实来源。
eMMC 与 UFS:寿命、接口能力和当前配置分别读取
手机内置闪存促使我进一步拆分“设备健康”。eMMC/UFS 的标准寿命字段给出估计档位,接口寄存器描述器件声明的能力,内核或 UIC 查询描述链路配置。把这些内容放在同一页面时,每一组都需要自己的来源和时效。
| 观测对象 | 当前读取方式与展示 | 能回答的问题 |
|---|---|---|
| eMMC 健康 | 对已核对身份的原生主用户区整盘执行固定 CMD8,保存完整 512 字节 EXT_CSD | 本次查询返回的寿命 A/B 档位、Pre-EOL 及适用字段 |
| eMMC 接口能力 | 解释 CSD 和 EXT_CSD 的声明位、HS_TIMING 配置 | 支持的 HS26/HS52、DDR52、HS200、HS400、电压与设备侧时序 |
| UFS 健康与身份 | 核对 ufshcd 关联后读取标准 sysfs 描述符属性 | 本次健康字段、实际返回的厂商和产品信息 |
| UFS 容量 | 分别解释器件可配置容量、所选 LU 的逻辑块大小与块数 | 器件、逻辑单元与 OS 所见容量各自的范围 |
| UFS 链路 | 保存 power_info 内核缓存,另通过 BSG 执行固定本地 UIC GET | 分来源观察 Gear、Lane、HS series 与电源模式 |
寿命 A/B 的 01~0A 表示十个百分点的已用寿命区间,0B 表示超过估计寿命,00 和保留码保持未知。页面保留原码与区间,Pre-EOL 单列;标准字段没有提供的累计 Host/NAND 写入量继续为空。这样可以保留器件实际提供的信息精度。
eMMC 的 CSD 时钟、最高声明模式和设备侧时序分组呈现。例如 CSD 的 26 MHz 与器件声明 HS400 能力可以同时存在:前者描述非高速模式的传输时钟,后者描述扩展模式能力。当前主机时钟和实测带宽仍需相应观测。BUS_WIDTH 不可回读,所以这条查询路径不据返回值推算当前位宽。
UFS 的内核缓存与主动查询也分别保留。缓存可能跨越休眠或状态切换;固定六项本地 DME_GET 查询记录主机收发 Gear、活动 Lane、HS series 与电源模式,每项保留响应和错误。读取可能唤醒设备,整组字段也可能跨越状态变化。器件规范版本、最高链路能力和当前配置因此各有独立含义。
原生读取使用固定查询集合,不提供任意命令入口。eMMC 拒绝 SD、boot、RPMB 与分区查询目标,UFS 核对所选 LU、控制器及 BSG 设备关联。取消或超时后,仍未退出的系统调用继续占有采集槽位和健康域租约,控制界面可以返回明确状态,同时避免第二次查询与旧调用重叠。
10 月 19 日的 Android AArch64 release-small 已在 Android 8 eMMC 与 Android 13 UFS 设备上完成单次只读健康查询。10 月 20 日增加的接口能力、UFS 容量和链路配置已有源码与离线解码合同,新增字段的实机采集、前后采样及 Linux 原生运行仍待对应环境验证。
识别能力先积累证据,再增加策略
后续设备接入包括更完整的型号识别、离线 ID 解码、经型号验证的 NAND 写入计数与写放大分析。通用 SMART 字段容易获取,厂商属性的单位、重置行为和适用固件却需要逐项确认;只有 Host 与 NAND 计数的范围、单位和时间窗能够对应,写放大比值才有解释价值。
温度、健康和设备型号的事实仍由 Device 返回。是否因温度暂停、某型号是否满足产线门槛、是否允许进入下一阶段,属于 Orchestrator 的策略。这样,同一条设备观测可以用于诊断、展示或生产判断,后续增加策略也有原始记录可查。
Orchestrator:把“多个任务”变成可管理的批次
单盘 Core 解决一次测试怎样正确执行,多盘环境还需要回答哪些任务可以一起开始、哪个任务已经占用资源、取消后何时能让下一块盘接替。pxdt-orchestrator 同时提供可嵌入的 Rust 库与本地命令入口;Workbench 的本机 Node 和独立 Node 都使用它管理计划、准入、worker 与归档。
计划固定以后,再让独立 worker 执行
一次批次拥有稳定 ID 与计划摘要。预检确认范围、参数和资源需求,提交后保存开始意图,再为获准执行的目标启动独立子进程。worker 直接调用 Rust Core;文件内容留在 worker 的数据路径中,进程间传递命令、状态与结果。C ABI 继续服务其他语言宿主,这条 Rust 执行路径无需绕一层 FFI。
独立进程让单个目标的异常有可监督的边界。最终结果通过原子归档提交,Orchestrator 同时保留计划、批次状态和原始 Core 结果。界面即使已经看到了“任务结束”,后端也要等进程退出以后才回收相应租约,防止旧进程仍持有设备或 I/O 时,新任务提前进入。
最新修复进一步保留编排层的撤销与拒绝原因。即使某个 worker 已留下部分或成功的 Core 归档,批次仍同时报告目标绑定失效、撤销等执行事实。工位状态文件损坏也只禁用依赖它的工位能力,默认目录任务可以继续按自身的卷守卫预检;固定工位任务则要求相关状态完整可用。
flowchart TB D[目标与配方草稿] --> P[预检并固定计划] P --> Q[保存提交意图与排队] Q --> A[检查预算和卷租约] A --> W[启动独立 worker] W --> E[Core 执行] E --> F[排空 / 终采 / 结果归档] F --> X[确认进程退出] X --> R[回收资源并准入下一任务]
并发需要同时满足资源与设备关系
资源准入分两段进行。准备阶段先保留控制和初始化所需额度;进入执行阶段,再依据 Core 给出的资源峰值取得执行租约。对于顺序执行的测试集,各资源维度取相应峰值,避免把不会同时出现的全部需求简单相加。I/O 缓冲预算之外还要考虑线程栈、分配器和内核开销,不能只用缓冲区大小预测进程总内存。
准入同时检查 Node 总预算、控制器分组预算、worker 配额和卷租约。单个任务自身超过配置上限时直接拒绝;只是暂时没有余额时进入等待。调度器在组之间轮转,以有限越过和错峰启动控制饥饿与启动峰值。它保留用户指定的 Q/T、块大小、缓存与后端,让等待原因可以解释,测量条件也保持确定。
当前 Workbench 草稿还没有把所有拓扑发现结果自动转成可信的控制器预算分组,缺少分类时仍走保守的未分类预算。拓扑图中出现两个控制器,只能说明发现层返回了这组关系;现场校准和资源策略接入后,调度器才能使用相应约束。自动识别关系、校准工位、资源分组这几步需要各自完成。
资源校准与自适应准入:已有后端能力及使用范围
后端已有资源校准和可选的自适应准入逻辑。校准至少读取三次不同的、完整结束的同配方 worker 执行,排除过短或失败的样本,并绑定节点、程序哈希、平台和配方,使用有期限的记录。这样,旧程序或另一台机器的观测不会自然变成本轮预算。
这类校准面向受限速的非 benchmark 任务。可选自适应调整后续能够准入的 worker 数量,运行中任务的 Q/T、缓存、块大小与算法保持原计划。性能测试继续强调工况一致,自动调参会改变成绩的含义。相关后端已实现,GUI 接入和不同设备组合的现场效果继续分项验证。
取消以后,还有一段必须完成的收尾
worker 的进程心跳说明控制线程还在响应,I/O 完成记录说明存储工作确实向前推进。两者分别观测,才能区分慢设备、等待中的系统调用与完全失联的进程。收到停止请求后,任务停止新提交,随后排空已接受的 I/O、完成终采、写出归档并退出;这期间继续持有必要租约。
超时和异常进入隔离处理。监督进程可以发现问题、限制新任务并保留诊断,驱动内部的请求是否完全结束仍需要平台提供的完成证据。这个设计把“已经请求停止”“正在收尾”“结果已保存”和“进程已退出”分开,也给以后接入格式化、重新挂载或设备复位留下明确的前置条件。
Node:让任务留在真正连接设备的机器上
Workbench 的本机模式在应用内承载 Node,通过进程内接口调用 Orchestrator;独立 pxdt-node 则把同一后端暴露给远程管理端。每个节点持有自己的批次、worker、状态和归档,桌面可以同时观察多个节点。目录和设备信息在目标节点上解析,远程测试不会误用客户端的磁盘清单。
flowchart TB APP[Workbench 桌面] -->|本机进程内接口| LOCAL[内嵌 Node] APP -->|HTTP/2 gRPC| REMOTE[独立 pxdt-node] LOCAL --> ORCH[pxdt-orchestrator] REMOTE --> ORCH ORCH --> WORKER[每目标独立 worker] WORKER --> CORE[pxdt-core 文件测试] ORCH --> DEVICE[pxdt-device 设备与拓扑观测] ORCH --> ARCHIVE[计划 / 状态 / 原始结果归档] ORCH --> LOCATE[独立定位服务]
当前节点连接面向可信内网:mDNS 发现开放节点,Workbench 自动连接并恢复管理与状态观察。需要认证的节点使用可选 token 与角色权限。Node 使用 HTTP/2 gRPC,已移除内置 TLS;远程部署的传输保护由 VPN 和网络访问控制承担。token 控制操作权限,通信加密需要部署环境提供。
桌面跨平台接入后,连接信息与可选 token 统一保存在普通 nodes.json 配置中,不加密,也不依赖系统凭据服务。复制这个节点库会同时复制访问凭据;日志隐藏 token,配方、工作区和结果的普通导出不包含节点库。需要认证的连接失败时,界面保留失败原因。
我把独立 Node 保持为设备旁的一项服务:它提供能力查询、目标解析、规划预检、命令提交、状态订阅和归档读取。管理端可以更新界面,设备机器可以继续无桌面运行;三平台桌面共用相同协议。高频进度快照允许合并,可靠结果通过最终归档读取,避免慢客户端把执行端拖进无限增长的消息队列。状态不变时只发轻量心跳,内容变化时才发完整快照,减少空闲时的重复序列化。
这轮架构优先做好单节点的任务所有权与恢复语义。多节点可以由同一个 Workbench 观察和管理,节点间的高可用接管、自动迁移执行与中央集群调度继续留待后续。存储任务依赖本机目录、挂载与真实设备,把一次未完成 I/O 的任务迁到另一台机器,需要远多于连接恢复的证据。
断线、重试、取消与关闭时,谁继续拥有任务
自动发现和连接不会开始、恢复或重放测试。每个节点保留独立草稿和预检,远程目录来自该节点允许的范围。连接失效时,桌面保留最后快照、显示过期状态并禁用操作;恢复连接后重新读取节点状态。
计划、预检、提交和查询构成完整控制链。持久命令使用稳定的命令 ID,相同 ID 和参数返回原回执;丢失响应时查询原 ID,避免一次点击因重试变成两次执行。服务重启后未确认的旧命令保留未知状态,旧计划失效,需要重新规划。
独立 Node 接受的任务在桌面断线后继续执行。关闭本机内嵌应用时,活动任务必须经过取消、排空、终采与归档;无法确认结束的 worker 保留需处理状态。普通操作和取消/关闭使用独立的有界执行额度,客户端的取消/关闭也使用独立连接,控制请求拥塞时仍为收尾保留容量;失败的取消请求可以由操作者重试。
当前服务可以前台运行并由进程管理器托管,Windows Service、systemd 和 launchd 的自动安装仍待完成。现有 Node 软件运行资料主要来自 macOS ARM64、本机网络和 RAM disk;跨机器部署、Windows/Linux 原生运行和真实多盘持续负载各自需要验收。
物理定位:从 NVMe 端口扩展到连接点与机箱盘位
工厂最初提出的需求,是把一块 NVMe 设备对应到具体工位、PCIe 端口或插槽。随着实现推进,我把问题拆成三层:操作系统看到了什么连接关系,现场把哪个位置校准成了哪个工位,以及当前任务究竟绑定哪一次设备占用。
通用拓扑将主机控制器、连接点、当前设备和块端点分开。USB Hub 下可以有多个端口,一个 USB 设备可能暴露多个 LUN;一个 NVMe 控制器也可以有多个 namespace。SATA 主机端口、SAS PHY 和机箱盘位各有不同的含义,需要有来源的关联才能串起来。当前已加入 Windows/Linux PCIe/NVMe、三平台 USB 以及 Windows/Linux SATA 的软件采集入口;macOS USB 采用尽力兼容方式,按系统实际可见的路径返回结果。
软件现在可以保存工位校准、跟踪设备占用代次,并在 Workbench 网格中保留空槽、失联槽和旧任务。真实主板、Hub、HBA、线缆和治具的对应关系仍须现场核对;某条路径缺失或枚举不完整时,状态保留未知,避免把查询失败解释成空口。
默认目录测试、固定工位执行和掉盘后的目标守卫
普通任务默认使用 directory_target,以目录和卷的身份守卫执行文件测试。需要固定工位约束时,计划显式选择 fixed_station,冻结工位修订、占用代次、设备实例与块端点。节点已有校准记录,也不会改变其他普通目录任务的策略。
校准时,操作者逐口插入已知介质,核对系统连接点与面板标签,再保存映射。主板、固件、控制器、Hub、线缆或治具布局改变后重新核验。盘符和系统磁盘编号可能改变,序列号跟随介质,临时 PCI 地址也受枚举影响,固定标签需要落在经过现场确认的位置关系上。
挂载目录的风险很具体:设备掉线后,同名路径可能退回系统卷上的普通目录。Core 在创建、重开和清理等关键位置检查绑定;Node 持续观察拓扑与占用,发现依赖关系失效后撤销任务,停止新提交并排空已接受的 I/O。绑定失效的任务要重新规划,不能在路径再次出现后直接继续旧计划。
Workbench 的发现顺序、系统磁盘编号序、硬件路径序与手工顺序只控制显示。排序、分组或移动卡片不会改变校准关系,也不会授予执行资格。一个物理工位可以显示多个 namespace 或目录任务;换盘之后,旧任务继续留在原工位并标明占用变化。
编排归档保留前后工位状态和 Core 原始结果。即使已经有部分成功结果,掉盘撤销或 worker 异常仍保留在批次状态中。真实热插拔、同路径替换、多 namespace 与相邻工位持续运行,是下一阶段现场验证的重点。
定位灯:把“找哪块盘”做成有期限的操作
最新一轮已加入机箱与盘位关联,以及独立的定位服务。Workbench 提供“定位 30 秒”和“停止定位”入口;Node 接收已经解析过的目标与指纹,复核后交给平台后端。Linux 首期使用内核 SES/enclosure 接口,Windows 使用 Storage CIM 的物理盘指示能力。
定位请求有期限和租约,由 Node 负责到期关闭及重启后的清理。断线、超时或关闭失败会保留待清理状态;旧的成功回执用于追溯,当前状态继续查询定位服务。这样,客户端窗口关闭后,定位操作仍有明确的责任方。
这部分已经完成软件接入,Linux/Windows 背板的实际灯态、故障灯保留以及对测试 I/O 的影响仍待实机验收。默认只对已有具体控制对象验收记录的组合允许测试中定位;未知组合拒绝并发定位,并保持当前测试继续运行。macOS 暂无通用本机灯控后端,桌面可以通过 Node 管理其他平台提供的能力。
机箱盘位证据还帮助区分“当前这块盘”和“这个槽”。已证实的空槽可以成为定位对象,但它没有可供文件测试的在线介质。定位成功也只回答该控制对象的指示操作,工位校准、设备身份和文件测试继续使用各自的证据。
平台取舍:把官方支持集中到能够持续维护的目标
跨平台一直是 PXDT3 的目标,但每增加一行发布目标,都会增加工具链、系统接口、ABI、最低系统版本和运行回归的组合。我在这一轮收缩了官方矩阵:Linux ARMv7 的 GNU/musl 路线,以及 Android ARMv7、x86_64,退出默认官方产物与回归范围;需要这些目标时,可以显式使用非官方平台构建入口继续尝试。
ARMv7 的负担尤其具体。交叉编译需要匹配 sysroot、GCC 与 libclang,Linux UAPI、io_uring 绑定和结构体布局也要在对应 ABI 上核对。存储测试还会跨越 4 GiB 文件偏移、URW 的 2 GiB 窗口和 32 位地址空间边界;文件偏移使用 u64,并不能消除缓冲区长度转为 usize、内存分配和底层系统接口中的限制。保留一个能编译的目标之后,还必须持续验证这些行为。
我因此优先把维护资源投入现代 64 位平台与已有的工厂兼容需求。这个选择按产品路线与验证成本决定:Android x86_64 随 Android ARMv7 一起退出官方范围,桌面的 x86_64 仍是主力;Windows x86 与单列的 Windows 7 目标也仍保留在 Core 矩阵中。老平台是否继续承担成本,要看它服务的现场是否明确、系统接口是否可控。
产品支持范围按层级划分:Workbench 面向 Windows 10 及以上的 x86、x86_64、arm64,Linux 的 x86_64、aarch64,以及 macOS 的 x86_64、aarch64;CLI/Core 额外保留 Windows 7 及以上的 x86、x86_64,并覆盖 Android aarch64 等无桌面场景。 arm64 与 aarch64 在这里都指 64 位 ARM 架构。
| 平台 | Workbench 支持范围 | CLI/Core 支持范围 |
|---|---|---|
| Windows | Windows 10 及以上:x86、x86_64、arm64 | Windows 7 及以上:x86、x86_64;另含 Windows arm64 目标 |
| Linux | x86_64、aarch64 | x86_64、aarch64,各含 GNU 与 musl |
| macOS | x86_64、aarch64 | x86_64、aarch64 |
| Android | 无 Workbench 桌面目标 | aarch64 |
截至本文更新,Workbench 的三平台共享入口已经接入,macOS 保留本机操作闭环;Windows ARM64 与 Ubuntu 24.04 GNU 的 x86_64、aarch64 已有完整构建记录。CLI/Core 的系统兼容范围独立维护,设备采集、定位灯等能力再按各模块的平台接口与硬件组合验证。
Core 官方构建矩阵将 Windows 7 兼容目标、Linux GNU/musl 分别列项,合计 12 个目标;构建矩阵与实机覆盖分别记录。64 位 ARM CPU 如果仍运行 32 位操作系统,也需要相应 ABI 的程序;AArch64 产物无法直接替代该环境的 ARMv7 程序。遇到必须保留的旧治具,可以维护独立构建与验收记录,再根据使用价值决定是否恢复官方支持。
Windows/Linux GUI 复用了共享视图和控制层,平台差异集中在系统数据目录、构建打包、快捷键和窗口关闭。Windows 调试 GUI 初始化遇到主线程默认栈不足,源码已将栈预留调整为 8 MiB;此前在临时调整栈的 ARM64 产物上已观察到中文 32 目标预览,新源码修复仍需重建 Windows 产物确认,x86/x86_64 也继续保留未完成项。
Linux 的验证已进入真实窗口:aarch64 容器在 X11 下完成 64 MiB tmpfs 写入校验、草稿恢复、图表与退出,在 Wayland 下检查了渲染、鼠标、缩放与 Ctrl+Q;x86_64 容器完成 X11 渲染、本机 Node 与退出,Wayland 尚未执行。这些记录使用 VM/容器与相应图形环境,实体 GPU、最低系统和完整发行依赖继续分别验收;首期 Linux GUI 范围仍为 GNU。
这项取舍也与前面的 SIMD 研究相呼应。x86_64 基线已有 SSE2,AArch64 基线已有 NEON,编译器在当前默认算法的提取样本中已经利用向量指令。继续投入时,我更关心真实数据生成、校验、内存流量与存储 I/O 的整体瓶颈,以及跨平台结果是否一致;手写更多指令后端需要可重复的收益来支持维护成本。
Android 13 Termux:从交叉构建走到实机写入校验
10 月 17 日,我在 Android 13 的 Termux 私有目录中运行了 AArch64 CLI 与 C ABI。先用 macOS 上的 Android NDK r30 构建 debug 产物,再在手机上执行普通文件测试。运行后端为有界线程池,回执记录缓存策略为 strict_bypass,各项结束后 I/O 已排空。
这次先验证内容与流程:三种算法都各自完成 16 MiB 写入校验,再通过独立命令重读;随后验证共享库加载、短时测速和主动损坏后的报错。手机能够实际执行这些路径,也暴露了交叉构建阶段没有发现的目录与证据保存问题。
| 实机项目 | 执行范围 | 观察到的结果 |
|---|---|---|
| 默认图样、H2testw、URWtest | 每种算法 16 MiB 写入与完整比较,再独立重读 | 六次结果均为选定范围通过,无数据错误 |
| C ABI 动态库 | 加载共享库并执行 1 MiB 文件任务 | 选定范围通过;该项使用程序化接口 |
| 短时 Bench | 普通文件性能测量流程 | 返回测速完成,保留测量与缓存/后端信息 |
| 单字节损坏 | 修改已有测试内容后重新校验 | 返回数据错误,记录一个错误单元 |
相对目录与证据保存分别修复
第一个问题出现在 --directory test-data --create-dir。绝对路径可以执行,新建的裸相对目录却报“no existing parent”:向上查找已有父目录时,路径最终走到了空祖先,没有按当前工作目录继续解析。我把目标先解析成绝对路径,再探测已有父目录;计划验证成功后才创建目录,保留原来的预检顺序。
修复后,单层目录、多层目录和 ./ 形式在 Android 上各完成 16 MiB 写入与独立重读,结果中的目录也保留解析后的路径。这个修复放在共享 Core 规划层,CLI 和其他使用相同计划入口的宿主共用。
第二个问题是 TUI 右下角显示“证据保存失败”。Android 应用目录中的硬链接受到限制,原本用于发布不可变记录的操作失败,即使采样只需要保存“SMART 不可用”也无法归档。我将 Android 发布路径改为禁止覆盖的原子重命名:临时记录完整写入并同步后,才用 renameat2(RENAME_NOREPLACE) 发布。
重新构建并部署后,三种相对路径用例都成功保存且读回归档;Android 上的不可变记录、并发发布和序列化失败测试通过。中文 TUI 显示 SMART“不可用”,保留采集失败原因,证据保存本身成功。文件测试的内容结论与健康信息是否可得,由此能够分别呈现。
之后,我又在 Android 13 Termux 上手动复测了 2220547 生成的 AArch64 release-small,也已全部通过。该次 CLI pxdt 为 64 位小端 ARM64 ELF PIE 可执行文件,动态链接,解释器为 /system/bin/linker64;面向 Android API 24,由 NDK r30(16248370)构建,已 stripped。
Android 发布方式与这轮实机证据的范围
Android 路径直接调用内核 renameat2,避开较新 Bionic 包装函数的加载依赖,保持 API 24 构建入口。目的文件已存在或系统调用不可用时明确失败,已有证据原样保留;其他平台继续使用各自既有的发布路径。
前面的逐项数据对应 6b189e1 基线及 5c1f616 修复版本的 debug 回执;release-small 复测结果由我随后手动确认,使用 Termux 自有可访问目录。短时 Bench 用于流程检查,手机吞吐和 CPU 效率尚未进行性能验收。产物另有 ELF 与 16 KiB 对齐检查,Android API 24 最低系统、16 KiB 页大小真机、OTG/SD 卡、SAF、权限撤销和长期负载继续留待对应环境验证。
10 月 20 日:把内核与权限差异纳入功能验证
这一轮 Android 验证扩展到 io_uring 选择路径,使用 AArch64 Debug 产物。内核 5.4 环境中,普通 Termux 的探测受到 SIGSYS 限制并自动选择线程池;root 上下文能使用原生队列。内核 4.4 环境中,普通进程同样受到策略限制,root 探测得到 ENOSYS 并回退。后端是否可用因此按调用上下文记录。
| 验证项目 | 已留存的功能结果 |
|---|---|
| 文件内容 | 16 MiB 写入和完整读回;原生路径覆盖 buffered 与已测文件系统上的 strict_bypass |
| 并发配置 | 原生 Q32T16,以及显式线程池 Q32T16、4 个 I/O worker |
| 自动矩阵 | 执行 T1 标准套件,记录 T16 跳过项 |
| SDK 嵌入 | 普通与 root 上下文中,四线程各三次 C ABI prepare |
| 队列生命周期 | 9 项 Android 原生队列回归,覆盖隔离、取消、短读与新文件写入等路径 |
这些记录回答了在对应内核、安全策略和本地目录下能否正确选择后端、完成任务及返回结果。持续吞吐、CPU s/GB 的后端比较、最低 API 系统与 16 KiB 页大小真机仍需要独立实验。现阶段我据此保留原生与显式线程池两种可解释的选择,不给出未经同工况测量的速度排名。
下一步:把软件闭环放进真实工位
截至 2026 年 10 月 20 日,PXDT3 已从文件引擎、CLI/TUI 和 C ABI,推进到共享设备观测、三平台 Workbench 入口、独立 Node、多目标编排与物理工位软件接入。最新一轮进一步补齐了移动端 I/O 后端选择、原生托管闪存观测、连续图表与终态一致性。软件能力逐步连接起来,接下来的验证重点是具体硬件组合与长期运行。
接下来,我按下面几条线推进。已有的软件接口提供了接入位置,验收仍围绕具体机器、设备与操作流程展开。
| 工作方向 | 已有基础 | 下一步接入与验证 |
|---|---|---|
| Workbench 与结果管理 | 三平台共享入口、配方库、离线结果,Windows/Linux 已有分项构建与窗口记录 | 完整批次历史筛选、保留策略、剩余架构/会话组合与原生桌面验收 |
| Android CLI/Core | 既有文件测试与 release-small 复测,新增内核 5.4/4.4 的后端选择、队列与 C ABI 功能记录 | 同工况后端性能、最低系统/页大小、外接存储、权限变化与长期负载 |
| Node 部署 | 本机内嵌与独立 gRPC 服务、命令回执与归档 | 服务安装、跨机器恢复、Windows/Linux 原生运行、在线权限撤销 |
| 设备识别与质量门槛 | 完整结构化 SMART、eMMC/UFS 原生健康、接口能力和链路配置的独立证据 | 新增字段实机采集、托管闪存前后采样、型号 NAND/WAF 与温控策略 |
| 工位与治具 | 拓扑、校准、占用代次、目录/固定工位守卫、定位服务 | 真机热插拔、同路径替换、背板灯态与相邻设备互不干扰 |
| 任务准备与维护 | 取消、排空、退出和资源回收的生命周期 | 完成收尾后的格式化/挂载辅助;有明确控制对象的复位或电源控制 |
| 工厂规模与追溯 | 批次计划、worker 结果和工位状态记录 | 从 2/8 台逐步扩展到 32/64/128 台的分级验收、长期负载与 MES 对接 |
规模扩展会涉及多个节点、控制器和测试批次。当前每节点每批最多 32 个逻辑目标、worker 配额 1~4 的约束仍然生效;更大的数字表示需要逐级完成的系统验收范围。真实板卡上的共享带宽、供电、温度、驱动超时与掉盘传播,会决定下一轮该调整哪一层。
从 ODT 到第二代工厂软件,再到 PXDT3,最初“生成数据、写下去、读回来”的想法一直保留着。现在围绕它形成了可复用的测试核心、观察设备的共享层、拥有任务的节点,以及面向操作者的工作台。接下来,我要把这些能力放到真实板卡与治具上,逐项确认设备、位置、执行和结果能够对应起来。
项目与参考资料
- iTXTech / OpenDriveTester:第一代项目;文件格式与读写实现见 Odtd.java。
- PeratX / libpxdt 与 PeratX / PXDriveTester:第二代测试库与桌面应用;参考源码分别固定于
cfd5b89、b59c253。生产使用与作者沟通经历来自我的项目回顾。 - H2testw 官方产品页:研究样本为 1.4;URWtest 使用固定的 1.8 fix 样本。
- CrystalDiskMark 与 Microsoft DiskSpd:性能测试方法及源码参考。
- AS SSD Benchmark 作者页面:研究样本为
2.0.7316.34247。 - PassMark BurnInTest V11 手册:流程参考;程序路径研究对应
11.1.1003固定样本。 - PXDT3 当前开发资料:
docs/architecture.md、docs/workbench-ui.md、docs/workbench-design.md、docs/workbench-cross-platform-plan.md、docs/orchestrator-runtime.md、docs/resource-admission.md、docs/worker-supervision.md、docs/node-rpc.md、docs/device-topology.md、docs/device-location-plan.md、docs/device-observation.md、docs/target-binding.md、docs/compatibility.md与docs/unofficial-builds.md;实现核对至 2026-10-20 的19bdf2e。Workbench 图片仍为 10 月 16 日实拍,桌面跨平台进展按构建与窗口记录更新。 - Android 实机记录:10 月 17 日 Android 13 Termux 的 CLI/共享库运行回执、相对路径与证据保存复测记录,对应
6b189e1、5c1f616;2220547的release-small手动实机复测结果由我在同日补充确认。Bench 图表与结果保存语义见50dd549、2220547及docs/benchmark-charts.md、docs/benchmark-profiles.md。 - 10 月 18~20 日更新:连续趋势与 100 ms 采样见
5ad7134、crates/pxdt-core/src/chart.rs和docs/benchmark-charts.md;结果与取消修复见e92a2d8,交互修复见f923e11、32738d9,权限标记见5bea42a。结构化详情与原生闪存观测见38e24d7、46e4f3b、dc1ad9b、e657bc0及docs/device-observation.md;Android 单次健康查询保留 10 月 19 日记录。io_uring 选择与功能验证见a8a8cc0、docs/benchmark-backends.md及对应 Debug 验证回执。接口示例中的合成回放数据仅用于说明解码合同。 - 编译器向量化资料:
docs/performance.md与research/evidence/compiler-simd-direction-e2dhdth_/留存的 Rust/LLVM 元数据、算法提取样本及六目标汇编;本文按该次编译观察说明 SSE2/NEON,性能测量范围在对应章节单独注明。 - 算法与方法资料:
docs/algorithms.md、docs/benchmark-profiles.md、docs/benchmark-backends.md、docs/core-plan.md、docs/burnin.md;原工具研究沿用 2026-10-14 留存的tool-research、hardware-acceleration文档记录及pattern-checks.json、as-ssd-test-model.json、bit-*固定样本证据。